
想把一个科学知识做成孩子愿意听完的小故事,可以把工作拆成四步:先定知识边界,再让模型写短故事;按页生成无字插图;最后排成绘本并配上旁白。先审内容再做成品,能减少把模型编出来的知识直接交给孩子的风险。
本篇用“小雨滴的旅行”做四页样例。下载完整练习包,解压后可看四页 PDF、55 秒旁白 WAV、故事 JSON、Qwen 提示词和原始输出、四张插图,以及排版与配音脚本。
第一步:给故事画出事实边界
先写清楚读者年龄、知识来源、故事允许说什么,以及哪些话不能说。这次只围绕水的状态变化:液态水可以变成水蒸气,水蒸气在合适条件下凝结成小水滴;云中的水滴长大后可能降水,水回到地面。教育部小学科学课程标准列有水的三种状态,以及观察生活中蒸发、凝结现象的学习要求;USGS 儿童版水循环说明还讲了云滴聚合、降水和地表径流,可对照核实本例故事。查看课程标准原文 · 查看 USGS 水循环说明
我把篇幅定为四页,每页 45–70 个汉字,主角“小滴”始终是透明、圆润的小水滴。结尾提醒孩子:水的旅程有很多种,不是每一滴都走同一条路线;观察问题也不需要碰热水或做危险实验。
第二步:让 Qwen 写初稿,再逐页校对
本机用 Ollama 的 Qwen3.8-27B 生成四页故事,API 单次推理约 24.5 秒。初稿虽然有四页,但每页只有 21–42 个汉字,没有达到提示词要求的长度;也没有清楚讲出水蒸气凝结的过程。我据课程标准扩写故事,补足“水蒸气凝成小水滴”,并把“云里的水滴长大后会下雨”改成“可能落下”,避免说成必然结果。原始输出与修订稿都在练习包里,正文展示的是修订后的版本。
提示词要求 JSON、每页长度、角色特征和可用事实范围。结构化输出方便后续脚本读取;但 JSON 正确不代表科学内容正确,仍要对照来源核每句话。完整提示词在 ZIP 的 Qwen绘本提示词.md。
第三步:按页做无字插图
使用本机 ComfyUI 的 Z-Image-Turbo,为每页分别生成一张横向插图。提示词里重复主角的颜色、形状和材质描述,并明确不生成文字;故事文字后续用排版脚本绘制,避免让图像模型直接写中文。插图风格和角色是否连贯,仍需把四页放在一起检查。
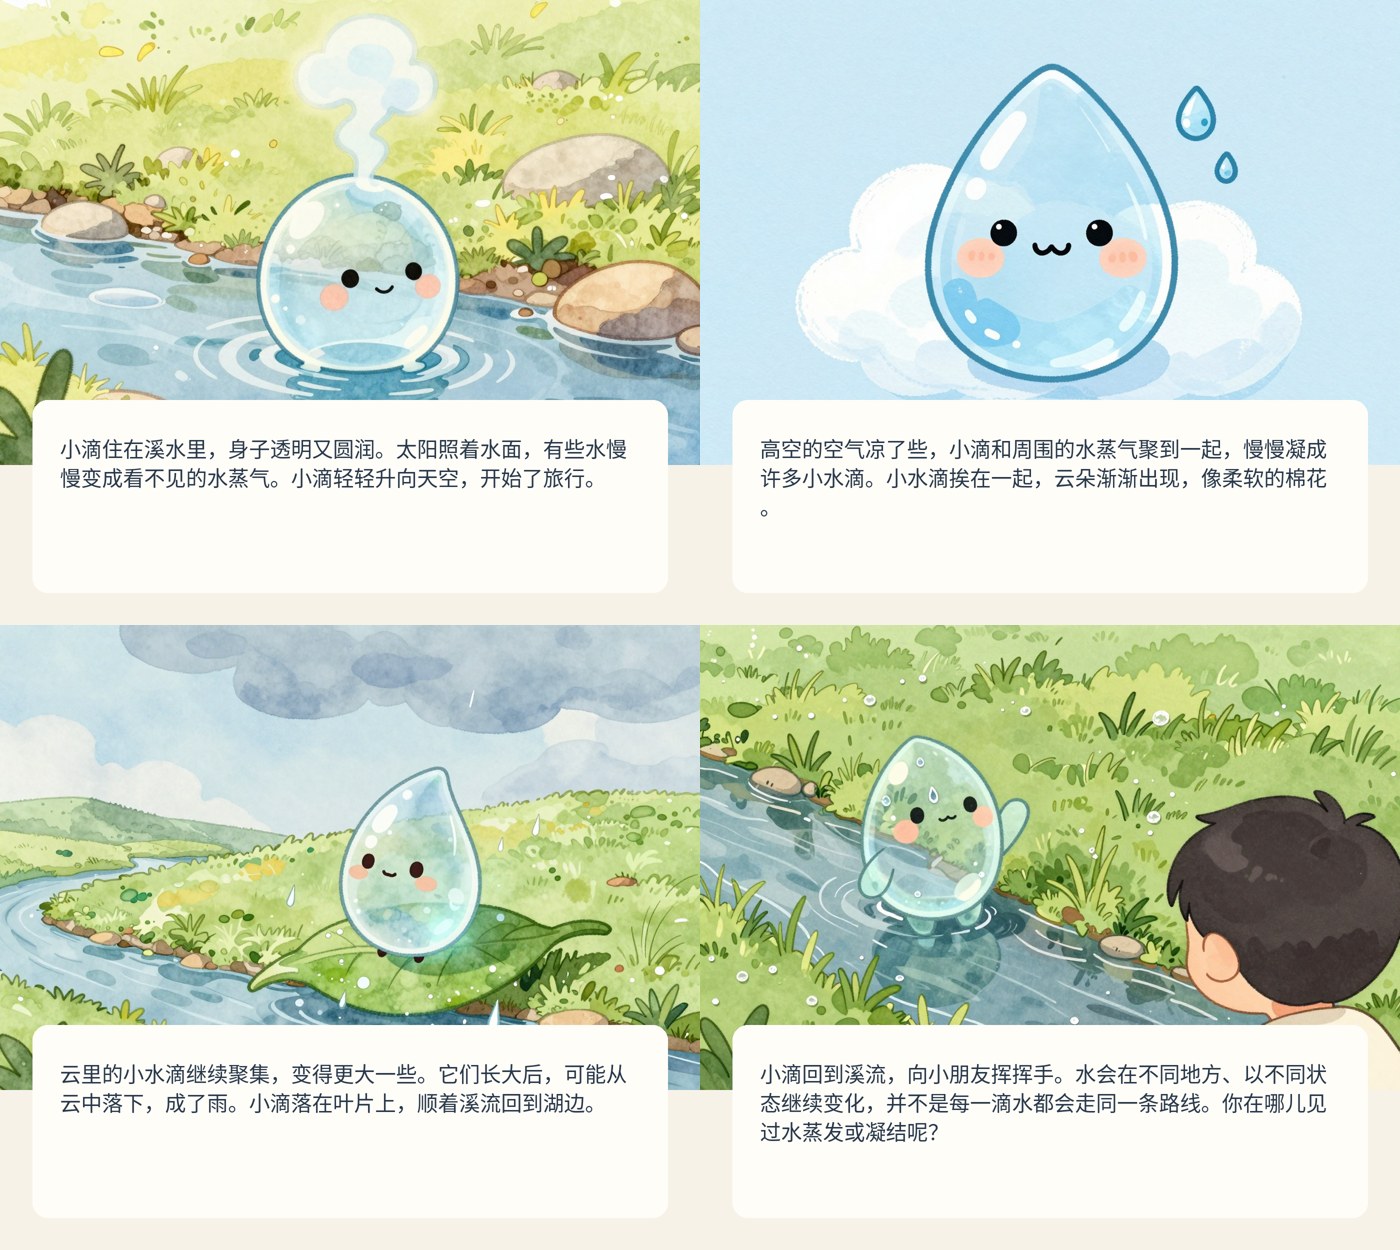 四页绘本插图预览:小滴从溪流升向天空、凝成云、随雨回到水边
这次四张插图都在本机生成,没有调用按张计费的在线生图服务。若角色在不同页面变化明显,优先固定同一张参考图并重新生成不一致页面;不要为了追求相似度把未经许可的真人照片作为参考。
第四步:排版成 PDF 并生成旁白
练习包中的 render_book.py 会把每张图放在上半页、故事文字排在下方,并输出四页 PDF。安装 Pillow 后运行:
python3 render_book.py --story story.json --images images \
  --font /你的中文字体路径/SourceHanSansSC-Regular.otf \
  --output 小雨滴的旅行.pdf
旁白使用 Fun-CosyVoice3-0.5B,并按官方示例调用仓库自带的 asset/zero_shot_prompt.wav 演示样音做零样本合成;不需要提供自己的录音。先按 CosyVoice 官方仓库安装依赖并下载模型,再在 CosyVoice 的 Python 环境中运行:
python make_audio.py --cosyvoice-dir /你的路径/CosyVoice \
  --output 小雨滴的旅行.wav
本机实测生成了约 1 分钟的旁白 WAV;脚本按页合成,并在页间留出短暂停顿。商业使用、发布或换成家人/儿童的声音样本前,应先核对样音授权、声音权益和儿童个人信息要求。本篇使用仓库演示样音,不包含用户提供的真人录音。
第五步:交付前检查
- 故事每页是否都在事实范围内,拟人化表达有没有被误读成科学因果。
- 角色外形、插图顺序、文字和旁白是否一致;PDF 中文字体有没有缺字或溢出。
- 播放整段旁白,检查漏字、错读、音量和页间停顿;这次只完成本机生成和文件检查,不把自动合成等同于人工听审。
- 家长或教师再按孩子年龄、阅读能力和当地教材做适龄性检查。
本次实测
Qwen3.8-27B 用约 24.5 秒生成故事结构;本机 ComfyUI / Z-Image-Turbo 生成四张插图;Pillow 脚本输出四页 PDF;CosyVoice3 用仓库自带演示样音做零样本配音。FunASR 自动识别旁白时,对“小滴/高滴”“水会/谁会”等近音字出现差异;我没有人工听审,因此音频保留为试听样例,正式给孩子使用前请先听一遍。全文、提示词、原始输出、插图、脚本和生成记录都放在练习包中,便于复跑和修改。
AI 生成的绘本适合作为亲子阅读或课堂备课的初稿,不是经过审定的教材。本次没有真实课堂试读,也没有完成教师适配评估。