
孩子做完一页练习,家长常要先抄题、再核答案,最后才知道该复习哪一类。可以把题目照片交给本机视觉模型,让它先转录题目和作答、按知识内容归类,再生成几道同类练习。模型整理的是复习线索;题目识别、答案和实际教学范围都要再检查。
本例用一张程序合成的“小数加减练习”照片实测。本机 Qwen 视觉模型读对了 5 道题和学生答案,正确标出 3 道需要复核的减法,并生成 3 道练习;我用十进制运算逐题复算,新题答案都正确。样例是清晰印刷字加轻微倾斜和阴影,不能代表手写作业或真实手机照片。
准备本机模型和练习照片
你需要一台能运行 Ollama 视觉模型的电脑。本次环境是 MacBook Pro M1 Max、64GB 内存、macOS 27,Ollama 0.35.1,模型为 qwen3.8-27b-vision。Ollama 本机列表显示模型约 17GB;首次下载需要联网和足够磁盘空间。Ollama 官方模型页标注 Qwen3.8 支持视觉输入;API 可把图片传给本机 Ollama 服务。查看模型页 查看图片输入说明
把练习页拍清楚,尽量让题目完整、光线均匀、镜头与纸面接近平行。拍之前遮住姓名、学校、班级和其他身份信息。本文练习包里的照片是合成样例,不含真实学生资料。
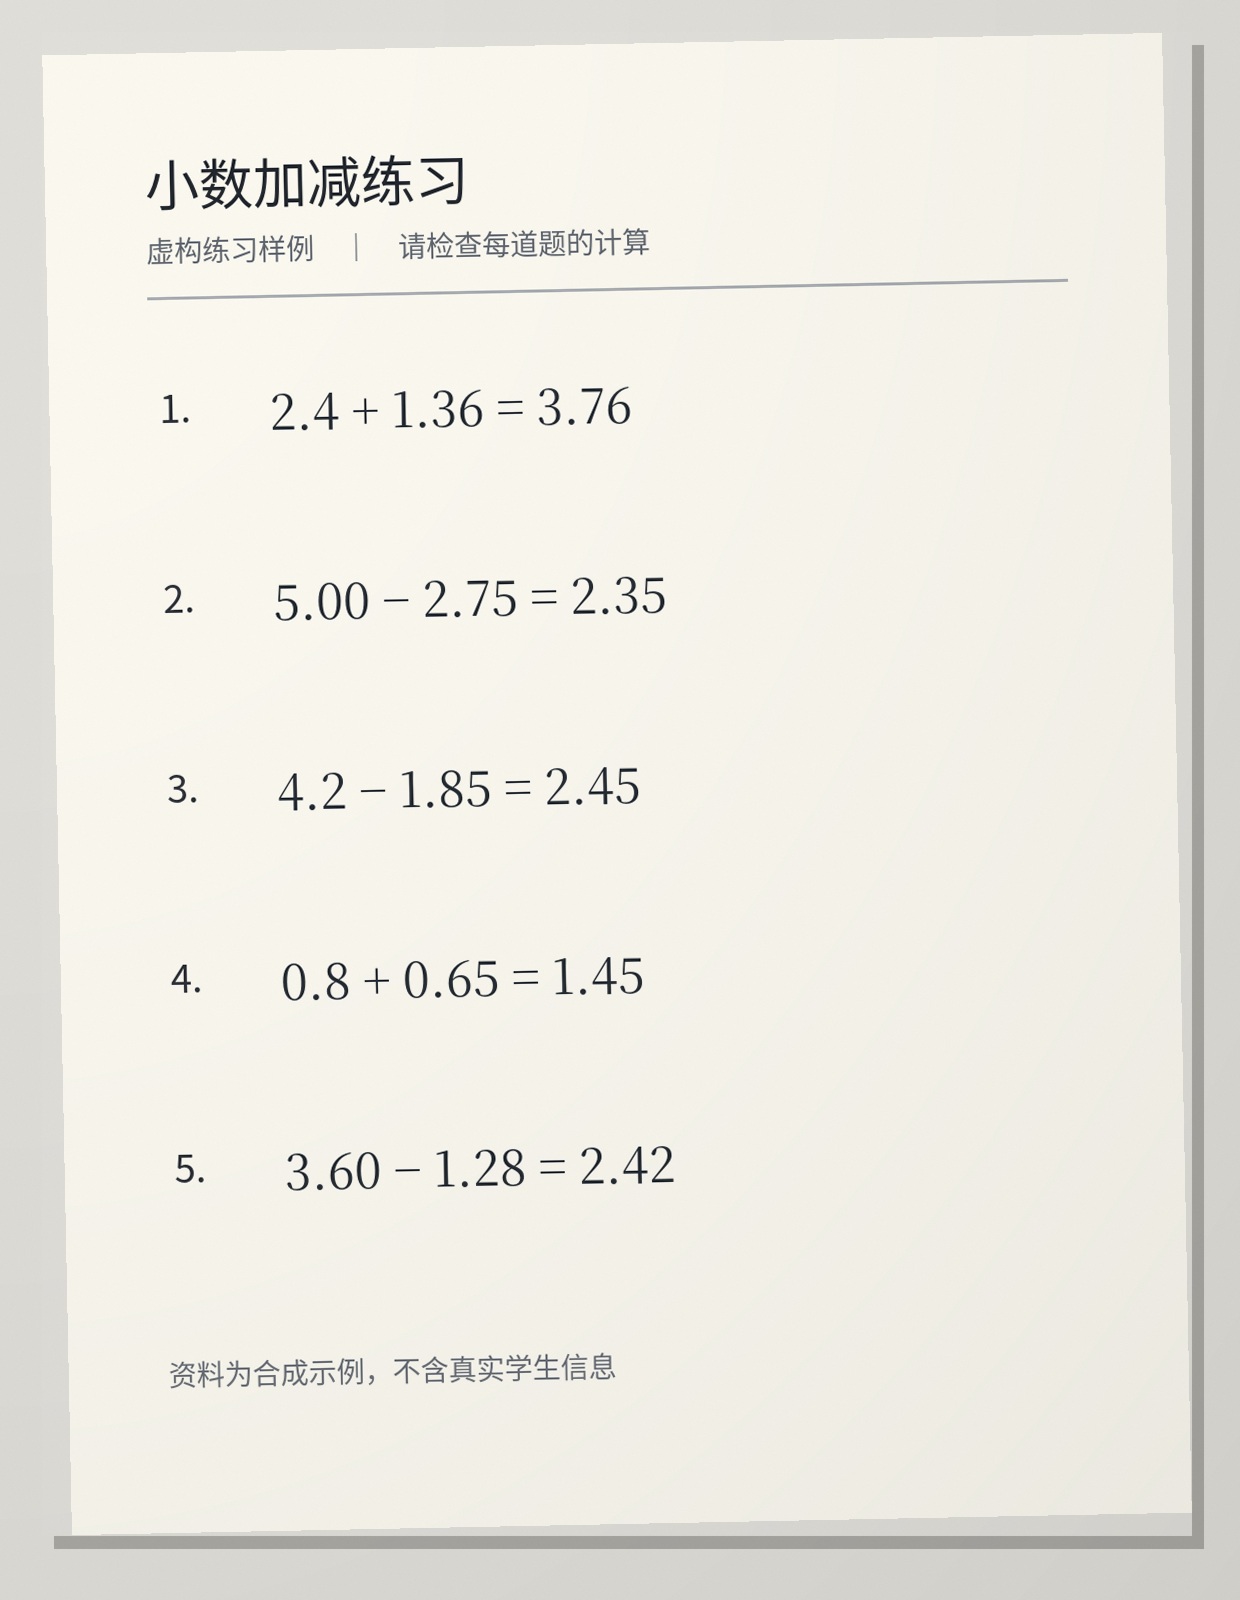 合成的小数加减练习照片,含五道题和作答
让模型先转录,再判断
下载错题整理练习包,解压后在练习包目录运行:
python3 s115_analyze.py 拍照样例.jpg脚本通过 127.0.0.1:11434 调用本机 Ollama,把提示词和图片交给 qwen3.8-27b-vision,并将结构化结果保存为 JSON。提示词要求模型逐题抄录、计算核对、按题目内容归类,并为错题生成 3 道类似练习;看不清时应标记不确定,不猜数字。
本次模型读到的五道题中,第 1、4 题结果正确;第 2、3、5 题标记为需要复核。抽查如下:
| 题目 | 照片中的作答 | 正确答案 | 模型标记 |
|---|---|---|---|
| 5.00 − 2.75 | 2.35 | 2.25 | 需复核 |
| 4.2 − 1.85 | 2.45 | 2.35 | 需复核 |
| 3.60 − 1.28 | 2.42 | 2.32 | 需复核 |
模型把这三题都归到“小数减法”。这只是题目内容的分类,不能据几道错题断定孩子不懂退位、数位对齐或某种固定错误原因。
我还用 macOS Vision 的本地文字识别工具读取了同一张照片:5 道算式也都读对,命令约 0.5 秒完成。单做印刷文字 OCR 时,系统识别更快;但它只提取文字,不会替你核算、归类或生成同类题。本文选择本机 Qwen 视觉模型,是因为本场景要完成这整段整理流程,而不是因为它在这张清晰样例上比系统 OCR 更准。两者都尚未用真实手写作业评估。Apple Vision 文字识别说明
复算答案,再做同类练习
Qwen 生成了下面三道小数减法练习:
6.00 − 3.45 = 2.55
5.5 − 2.35 = 3.15
4.80 − 1.56 = 3.24
我用 Python Decimal 分别复算,三题答案都通过。你也可以用计算器核对,但不要只检查模型给出的答案:先把题目读一遍,再独立算一次。错题本可以记录“知识内容、原题、正确答案、复习日期”,不需要记录对孩子能力的主观判断。
如果要进一步出一份包含多个知识点的练习卷,可以参考先定知识范围,再生成并校验练习卷。作文类反馈的人工复核方式见按量表逐条检查作文建议。
复核和隐私边界
- 对照照片逐字检查题目、运算符和作答;任何一个符号看错都会改变答案。
- 把模型标记的“需复核”当作核查入口,不直接当作老师的错题结论。
- 每道新题都单独重算;再确认年级、教材版本、已学知识和题目难度适合当前复习。
- 本例走本机 Ollama 地址,图片没有发送给云端模型;模型首次下载仍需联网。实际使用时仍应保护本机文件和备份。
- 不满十四周岁未成年人的个人信息属于敏感个人信息,处理时应取得监护人同意。演示和测试优先用虚构题目;确需整理真实作业时,先去除可识别信息,并确认学校和家庭的处理要求。查看《个人信息保护法》第二十八、三十一条
教育部数学课程标准把小数运算放在“数与运算”内容中,强调理解算理、掌握算法;本练习只是小范围算术示例,不是课程标准题库,也没有经过教师课堂评估。查看数学课程标准
这次仅测试一张合成的清晰印刷题目照片,未测试手写、模糊或遮挡图片,也未验证其他学科。模型读图和计算都有出错的可能,保留原图并由家长或老师复核后再把新题交给学生。