
民宿日常物料可以分开处理:房间图先守住真实布局,点评回复先核事实,多语种介绍只翻已确认的房型信息。本文用完全虚构的“双床房”资料,分别在本机 ComfyUI 和 Ollama/Qwen3.8-27B 上跑一遍。示例不代表真实门店,也没有使用真实住客点评或订单资料。
草图、ComfyUI 提示词、虚构事实卡和脚本放在酒店民宿 AI 物料练习包。包内 evidence/qwen-run.json 保留模型原始回答与 token 数据,evidence/comfy-run.json 记录图像生成参数,便于和修订结果对照。
先整理一张事实卡
样例设定为“云汀小院”(虚构),房型事实只有:28 平方米、两张 1.2 米单人床、无阳台、独立淋浴间且无浴缸、不含早餐、15:00 后入住、12:00 前退房。完整数据在包内 facts.json。如果真实门店没有确认面积、床宽、早餐或时间规则,就不要把它们交给模型当作已知事实。
房型图:先做空间概念,不替代实拍
我用 Pillow 画了一张没有文字的双床房平面构图草图,再通过 ComfyUI 本机 API 和 FLUX.2 Klein 4B Distilled 做图像编辑。生成耗时 74.72 秒,输出 880 × 1168。结果保留了两张床、窗和中间通道;模型还补出一个柜体,因此这张图只能用于虚构空间的风格沟通,不能直接当成真实房间照片或设施证明。
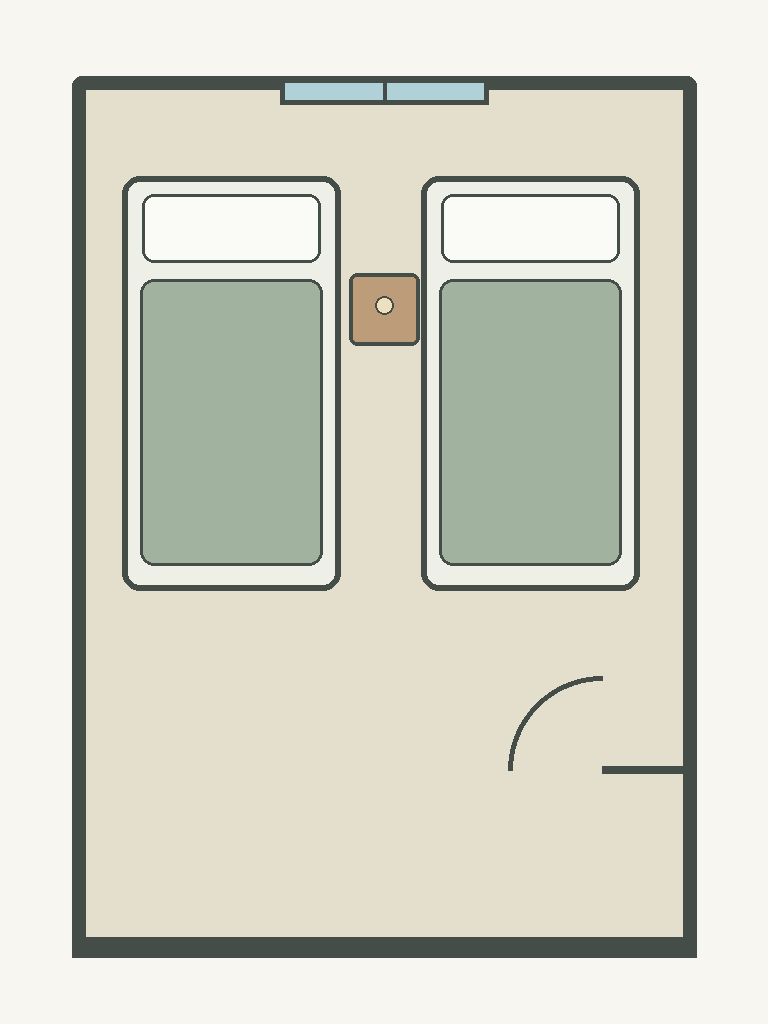 虚构双床房的平面构图草图
 ComfyUI 生成的 AI 双床房空间概念图,标注为虚构样例
练习包里 scripts/generate_room.py 只连本机 127.0.0.1:8188。官方 ComfyUI 指南列出了 FLUX.2 Klein 4B Distilled 编辑工作流和模型组件;本机使用的模型文件名是 flux-2-klein-4b.safetensors,指南当前列出的名字是 flux-2-klein-4b-fp8.safetensors。如名称或节点不一致,按当前 ComfyUI 版本和本机模型文件修改,不要只改提示词来掩盖加载错误。ComfyUI 官方指南
在本机复现
解压练习包,Python 环境安装 Pillow 后,先启动 ComfyUI 并确认对应模型已加载:
python3 -m pip install Pillow
python3 scripts/draw_room_sketch.py
python3 scripts/generate_room.py
再启动 Ollama,运行 ollama list 确认本机有 qwen3.8-27b:latest,然后运行:
python3 scripts/run_qwen.pyQwen 脚本用标准库,不需额外 Python 包;它只请求本机 127.0.0.1:11434。如果本机模型名字不同,改 scripts/run_qwen.py 顶部的 MODEL。ComfyUI 的模型文件名也要与 scripts/comfy.py 一致。
做真实房型上架图时,应使用住客实际预订的房间照片。生成模型可能增加柜子、窗户、阳台或床位;即便画面更漂亮,也不能用概念图冒充现场实拍。图片里的可见 AI 标识也要保留。FLUX.2 Klein 模型卡
点评回复:先核模型有没有替门店作承诺
本次输入的是一条虚构点评:“房间挺干净,两张床睡着舒服。夜里走廊有人说话时能听见,睡眠浅的话有点受影响。”我把房型事实和点评分别放进提示词,通过本机 Ollama Chat API 请求 qwen3.8-27b:latest,关闭思考输出。脚本和提示词见 scripts/run_qwen.py,运行数据及原回答保存在 evidence/qwen-run.json。
首次本机回答耗时 21.29 秒(215 输入、57 输出 tokens),补了一句“虽无阳台,但力求提供舒适睡眠环境”,还提出后续管理动作。练习包干净解压后再次运行耗时 16.42 秒(215 输入、51 输出 tokens),又出现事实卡没有的“隔音效果有限”。两次结果不同,说明不能复用未经核验的模型句子;即使带 [待店主确认],也不能直接复制到公开回复。两次原始记录见包内 evidence/qwen-run.json 和 evidence/clean-extraction-qwen-run.json。可以先核对当晚情况,再由店主确认实际措施后改写,例如:
谢谢您反馈夜间走廊说话声影响休息,很抱歉。我们先核实当晚情况,再根据实际处理结果回复。
只有门店确实会核实并跟进时,才使用“我们先核实”等承诺。点评文字练习使用虚构内容;处理真实评价时不要把住客姓名、订单号、手机号或含个人信息的截图直接送入模型。个人信息处理应结合《个人信息保护法》、门店业务安排和所用服务的实际数据流逐项判断。法律原文
多语种介绍:逐字段对照,不让模型添加卖点
首次翻译请求耗时 13.11 秒(202 输入、154 输出 tokens);干净解压复跑耗时 12.99 秒(202 输入、156 输出 tokens)。两次生成的面积、床数与床宽、阳台、淋浴和浴缸、早餐、入住退房时间字段均与事实卡一致。英文开头是“The Yunting Twin Room is 28 square meters in size and features two 1.2-meter single beds.”;日文开头是“雲汀ツインルームは28平方メートルで、1.2メートルのシングルベッド2台を備えています。”。本例只核对了明确字段,没有请英语或日语母语者润色;正式接待海外客人前仍需校对房型专用词和实际入住规则。
Ollama 的 Chat API 响应包含生成文本与耗时、token 等字段,模型支持时可通过 think: false 关闭思考输出。Ollama Chat API Qwen3.8-27B 模型卡也说明默认思考模式可按请求关闭。Qwen3.8-27B 模型卡
发布前的最后检查
- 房间图:对着实拍确认床位、窗、门、卫浴和景观;AI 新增或移除的内容都要删除或重做,不能当成真实房况。
- 点评回复:把模型提到的退款、补偿、联系、整改和时间承诺逐句列出,只留下门店能够执行且已经确认的内容。
- 多语种介绍:数字、床型、早餐和入住时间逐字段回查原始资料;不确定项留空,不用“附近”“景观”“免费”等词补足文案。
- AI 标识:本包概念图内含“AI生成空间概念图 · 虚构样例”标识。按照《人工智能生成合成内容标识办法》,通过网络信息内容传播服务发布生成合成内容时,还应主动声明并使用平台提供的标识功能。办法原文
本次只验证一张虚构空间概念图和两次本地文本生成;没有使用真实住宿照片、真实住客资料或任何OTA账号,也没有验证实际房间、平台排序、真实客诉处理或母语级文案质量。