
想做一门能交付给学员的小课,可以先把一个具体技能拆成课程大纲,再写逐课讲稿、制作示意图,最后配上旁白。本文用“小店怎样在自然光下拍一张清楚的陶瓷杯照片”做样例,产出三课蓝图和第一课讲稿。课程图示由简单图形排成,AI 配音只在本机做了生成测试;因模型卡带有学术用途免责声明,样音没有放进公开练习包。
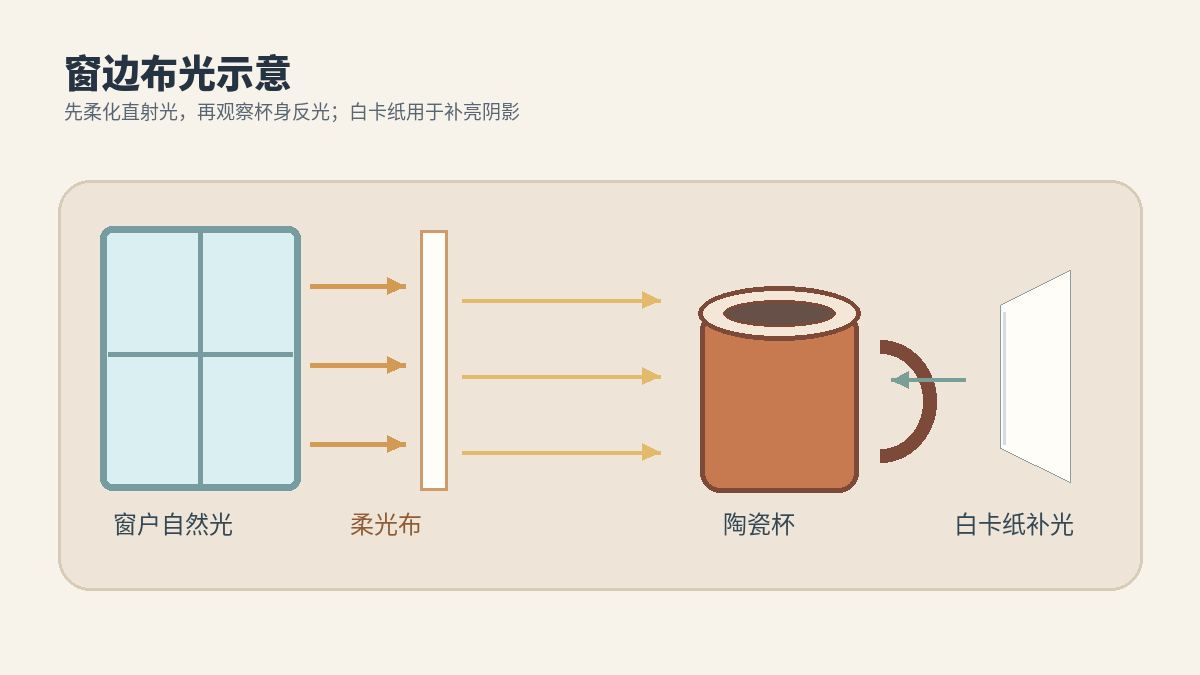 窗边布光示意:用柔光布柔化光线,以白卡纸补亮阴影
准备一台本机和一个明确主题
| 项目 | 需要准备 |
|---|---|
| 电脑 | 本例为 M1 Max、64GB 内存的 Mac;较小内存设备未验证 |
| 课程主题 | 一件你确实会做、能演示和复核的事 |
| 工具 | Ollama + Qwen3.8-27B;可选 CosyVoice 3 本机配音 |
| 空间 | Qwen3.8-27B 本地模型约 18GB;CosyVoice 另需较大的项目与模型文件,按安装教程预留磁盘 |
| 时间 | 本例大纲生成约 46 秒,第一课配音生成约 85 秒;审稿、画图和剪辑另计 |
如果还没安装,可先看本机运行 Qwen3.8-27B和Mac 本地部署 CosyVoice 3。Ollama 提供本地模型运行服务;Qwen3.8-27B 模型卡标注 Apache 2.0 许可,当前 Ollama 模型页列出约 18GB 的下载版本。查看 Ollama 模型页 · 查看 Qwen 模型卡
第一步:先写学员能完成什么
别先让模型“做一套完整课程”。先写清楚谁来学、学完要完成什么、哪些内容不在课程范围里。这个样例的目标是:学员能拍一张主体清楚、便于后期裁切的陶瓷杯照片;不承诺照片能提高销量。
再把目标拆成三课,每课对应一个可以检查的结果:
| 课程 | 学员要做的事 | 这一课的交付 |
|---|---|---|
| 找到柔和光线 | 观察杯身反光,调整杯子或光线 | 一张反光较柔和的照片 |
| 构图与裁切 | 留出空间,再按发布版式裁切 | 原图和两种尺寸预览 |
| 对焦与交付 | 放大检查细节、背景和商品一致性 | 一张复核后的照片 |
把练习包里的提示词交给本机 Qwen,让它按同样的字段起草。提示词要求模型只写操作步骤,不编平台规则、效果保证或固定比例。生成后先看每课目标是否重复、课与课之间是否有顺序,再决定保留哪些内容。
这次 Qwen 在约 46 秒内给出了三课大纲、讲稿、配图描述和检查表。不过它没有达到提示词要求的讲稿长度,还写了“至少留白 20%”和“照片清晰了一半”这样的无依据说法,并把白卡纸描述成遮光工具。我保留了原始输出,并在练习包里放了修订稿。先把模型输出当草案;如果步骤关系到专业结论,要找懂这门技能的人核对。
第二步:每课只讲一个动作
第一课讲“找到柔和光线”。下面这段讲稿约半分钟,先说明要做什么,再给检查方法:
先把杯子放到窗边,避开阳光直射。拍摄前看一眼杯身:如果有刺眼的亮斑,可以移动杯子或手机,让反光离开正面;也可以在窗边加柔光布,让光线更柔和。白色卡纸可以放在阴影一侧补光,别把它误当成遮光布。拍完后放大检查杯口和边缘,再留一份没有裁切的原图,后面做不同尺寸时再裁。亮面商品可能映出反光板的形状,摆好后再看杯身高光;反光板可能让反射区域更亮,按实物效果调整位置。Adobe 产品摄影说明
把每个动作都写成“做什么—观察什么—不合适时怎么调整”。模型生成的数字、效果保证和“行业标准”都要找到可靠来源;查不到就删掉,或者改成由学员按自己的平台尺寸检查。
第三步:用示意图讲清空间关系
这张图只用窗户、柔光布、杯子和白卡纸标出大致位置。画空间关系时,PowerPoint、Keynote 或矢量绘图工具里的基本形状往往比 AI 生图更容易检查;如果要展示某个商品的真实颜色、材质和细节,就用实拍图,不要用 AI 生成图冒充商品实拍。
把一页控制在一个主要动作。照片、箭头和标签各自说明同一件事;别让装饰抢走注意力。课程交付前,把图放到手机上看一次,确认字和关键物体在小屏幕上仍看得清。
第四步:生成旁白,再检查音频完整性
想在本机生成旁白,可以按CosyVoice 安装教程准备环境,再下载练习包,用其中的 make_voiceover.py 读取讲稿文件。脚本会把模型返回的所有音频分段接起来,避免长句只导出开头一段:
~/ai-demo/CosyVoice/.venv/bin/python make_voiceover.py \
  --cosyvoice-dir ~/ai-demo/CosyVoice \
  --text 第一课讲稿.txt \
  --output 第一课旁白.wav
本机合成约 29.5 秒语音,用时约 85 秒。FunASR 转写基本覆盖了整段内容,但把“原图”识别成了“沿图”,也在“柔和”处多了停顿,所以自动转写只能帮你找疑似漏字的位置。发布前从头到尾听一遍,核对数字、专有名词、停顿和音量,再和画面逐句对齐。
Fun-CosyVoice 3.0 支持中文等多种语言,模型卡标注 Apache 2.0;同一页面也写有“仅供学术目的”的免责声明,没有解释这句话对模型权重和生成语音的商业使用范围意味着什么。它适合本机验证和制作草稿;用于收费课程前,先向维护者确认许可范围,或改用许可明确且取得声音授权的配音方案。查看 CosyVoice 模型卡
第五步:审核后再发布或售卖
- 核对课程事实、演示步骤和讲稿;保留有来源的内容,不把 AI 补出的数字当成标准。
- 核对配图和实物是否一致;把照片裁成目标平台尺寸后,再确认关键信息没被裁掉。
- 听完整段旁白,确认没有漏段、错读或与画面不一致的地方。
- 收费前确认课程所用文字、图片、音乐、示例录音和字体的授权。著作权法涉及复制、发行及通过信息网络向公众传播作品等权利;不要直接搬用他人的课件、配乐或声音。查看《著作权法》
- 发布 AI 生成的文字、图片或音频时,按发布平台提供的功能主动声明并添加标识。《人工智能生成合成内容标识办法》自 2025 年 9 月 1 日起施行。查看办法原文
拿它做一门小课
先从你能亲自演示的一个问题开始,做一节试讲。可以先问现有客户、社群成员或公众号读者,看看他们是否会为这个具体结果付费,再根据试学反馈补课。查看目标平台上同类课程的公开定价和交付形式,再根据课时、答疑、更新和授权成本定价;没有查到的市场价不要凭空估。收费课程的效果要靠真实学员反馈验证,模型生成得快不代表有人愿意购买。
工具和练习包
| 工具 | 用途 | 本例限制 |
|---|---|---|
| Ollama + Qwen3.8-27B | 起草课程结构和讲稿 | 本机生成约 46 秒;原稿出现了无依据比例和效果保证,必须人工审核 |
| Fun-CosyVoice 3 | 本地生成旁白草稿 | 约 29.5 秒音频生成约 85 秒;商业使用前先确认模型卡免责声明 |
| PowerPoint / Keynote 等形状工具 | 绘制可检查的教学示意图 | 本例图由基本形状绘制,不代表真实拍摄效果 |
下载知识课制作练习包,里面有提示词、模型原始输出、人工修订后的课程蓝图、第一课讲稿、布光示意图、配音脚本和实测记录。旁白没有放入公开包,因为当前 CosyVoice 模型卡对商业用途的说明不够明确。
本例没有用真实杯子和手机完成拍摄,也没有学员试学、销售或教学效果测试。样例只演示怎样把一门短课拆成大纲、讲稿、示意图和配音草稿。