想在自己的 Mac 上试 Qwen3.8-27B,可以下载社区制作的 GGUF 量化文件,再用 Ollama 导入。本文给出 Q4、Q8 两条命令,适合想在本机对话、并愿意下载十几到几十 GB 模型文件的人。
我们在 M1 Max、64GB 内存、Ollama 0.35.1 上用已缓存的 Q4 和 Q8 模型各跑了一次相同的简单问题。都回答了“2+3=5”;本次输出速度分别是 13.50 和 11.40 tokens/s。单个简单问题不能代表模型整体能力,也不能当成其他电脑的速度保证。
先判断电脑能不能跑
| 配置 | 建议 |
|---|---|
| Apple 芯片 Mac,64GB 统一内存 | 本文实测配置,Q4、Q8 均成功运行 |
| 32GB 内存 | Q4 可以尝试,但先降低上下文;模型运行时还要给系统和其他 App 留内存 |
| 16GB 内存 | 不建议从 27B 开始,先选更小的模型 |
磁盘文件大小不等于模型运行时的内存占用。本文这台 64GB Mac 在 262,144 上下文下,ollama ps 显示 Q4 运行占用约 34GB、Q8 约 46GB;这是本机一次运行数据,不是所有设备的固定值。上下文越长,内存需求通常越高。Ollama 官方建议用 ollama ps 查看实际分配的上下文和处理器占用。
还没安装 Ollama?先看《Mac 上怎么本地跑大模型?》。本文不需要 Python,也没有额外脚本;需要的 Modelfile 已放在下载工具包里。
1. 选一个 GGUF 量化文件
Qwen 官方模型卡发布的是原始模型权重;下面的 GGUF 文件由 LM Studio Community 转换并量化,方便 Ollama 等工具使用。量化会减小文件体积,也可能影响回答质量。下载前打开社区仓库文件页,核对文件名、版本、体积和该仓库的授权说明。
Qwen3.8-27B-Q4_K_M.gguf:文件较小,先从这个版本开始。Qwen3.8-27B-Q8_0.gguf:文件更大,留给内存充足、想比较量化差异的电脑。
仓库里的具体文件名、大小和下载方式可能变化。不要用旧截图里的速度或文件体积估算你现在的下载时间。Qwen 官方基础模型卡标注 Apache-2.0;社区转换仓库的说明和授权也要单独查看,商用前核对你实际下载的文件来源及许可。
建一个专用目录,把仓库页面提供的 Q4 或 Q8 文件下载进去。若你已经复制好该仓库的直链,可用 curl 续传;把 URL 换成页面当前显示的文件地址:
mkdir -p ~/ai-models/qwen38
cd ~/ai-models/qwen38
curl -L -C - -o Qwen3.8-27B-Q4_K_M.gguf 'https://modelscope.cn/models/lmstudio-community/Qwen3.8-27B-GGUF/resolve/master/Qwen3.8-27B-Q4_K_M.gguf'
这条直链在 2026-10-09 做过 HTTP 头检查,返回 200;下载文件很大,实际速度取决于网络。下载完成后,先在 Finder 或终端确认文件名与实际选择的量化版本一致;磁盘空间不足时不要同时保存多个几十 GB 的模型副本。
2. 用 Ollama 导入 GGUF
把工具包里的 Modelfile.q4 复制到模型文件所在目录。文件内容只有一行:
FROM ./Qwen3.8-27B-Q4_K_M.gguf在这个目录打开终端运行:
ollama create qwen3.8-27b -f Modelfile.q4
ollama list
看到 qwen3.8-27b 后,先运行一次简单问题:
ollama run qwen3.8-27b --verbose '请用一句话介绍你自己,并告诉我 2 加 3 等于几。'等回答结束后,查看 Ollama 实际加载情况:
ollama ps它会显示正在运行的模型、运行占用、处理器和上下文。本文本机样例里 Q4 回答正确,生成速度为 13.50 tokens/s,ollama ps 显示约 34GB 和 262144 上下文。结果只代表 M1 Max 64GB、Ollama 0.35.1 上这次测试。
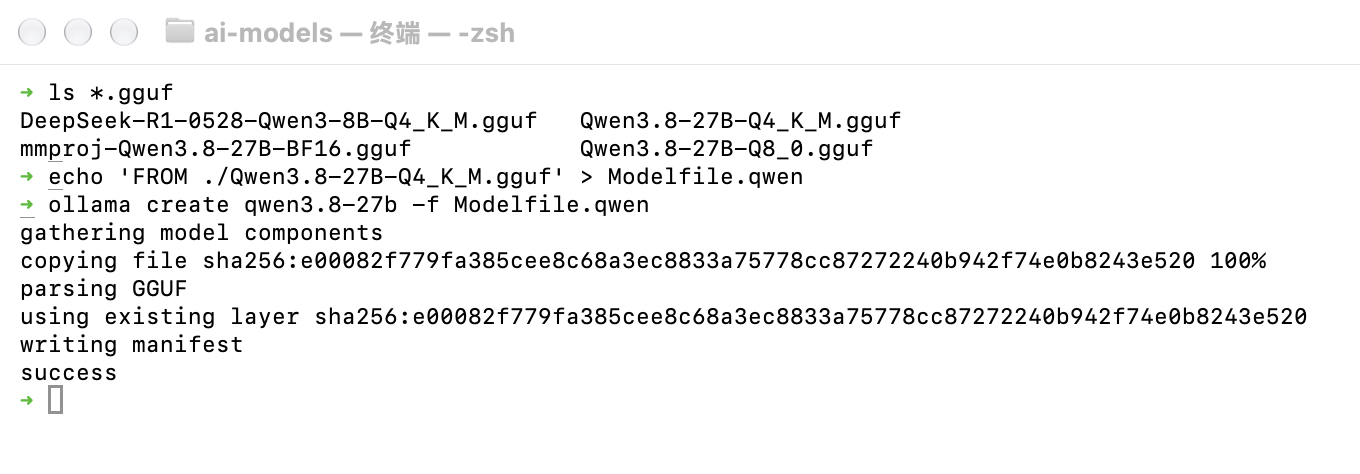 2026-10-03 历史截图:Ollama 导入 Qwen3.8 GGUF 的终端记录,当前命令以本文步骤为准
3. 有余量再比较 Q8
Q8 文件更大。需要比较时下载它,再把工具包里的 Modelfile.q8 放到 GGUF 文件旁边:
curl -L -C - -o Qwen3.8-27B-Q8_0.gguf 'https://modelscope.cn/models/lmstudio-community/Qwen3.8-27B-GGUF/resolve/master/Qwen3.8-27B-Q8_0.gguf'确认文件名与下载文件完全一致:
FROM ./Qwen3.8-27B-Q8_0.gguf导入时换一个 Ollama 名称,避免覆盖 Q4:
ollama create qwen3.8-27b-q8 -f Modelfile.q8
ollama run qwen3.8-27b-q8 --verbose '请用一句话介绍你自己,并告诉我 2 加 3 等于几。'
ollama ps
同一台 M1 Max 64GB 上,这次 Q8 回答了正确算术结果,速度为 11.40 tokens/s;ollama ps 显示约 46GB 和 262144 上下文。Q8 运行时给系统留下的空间更少。一般先用 Q4;只有确认内存和磁盘都够,再考虑 Q8。
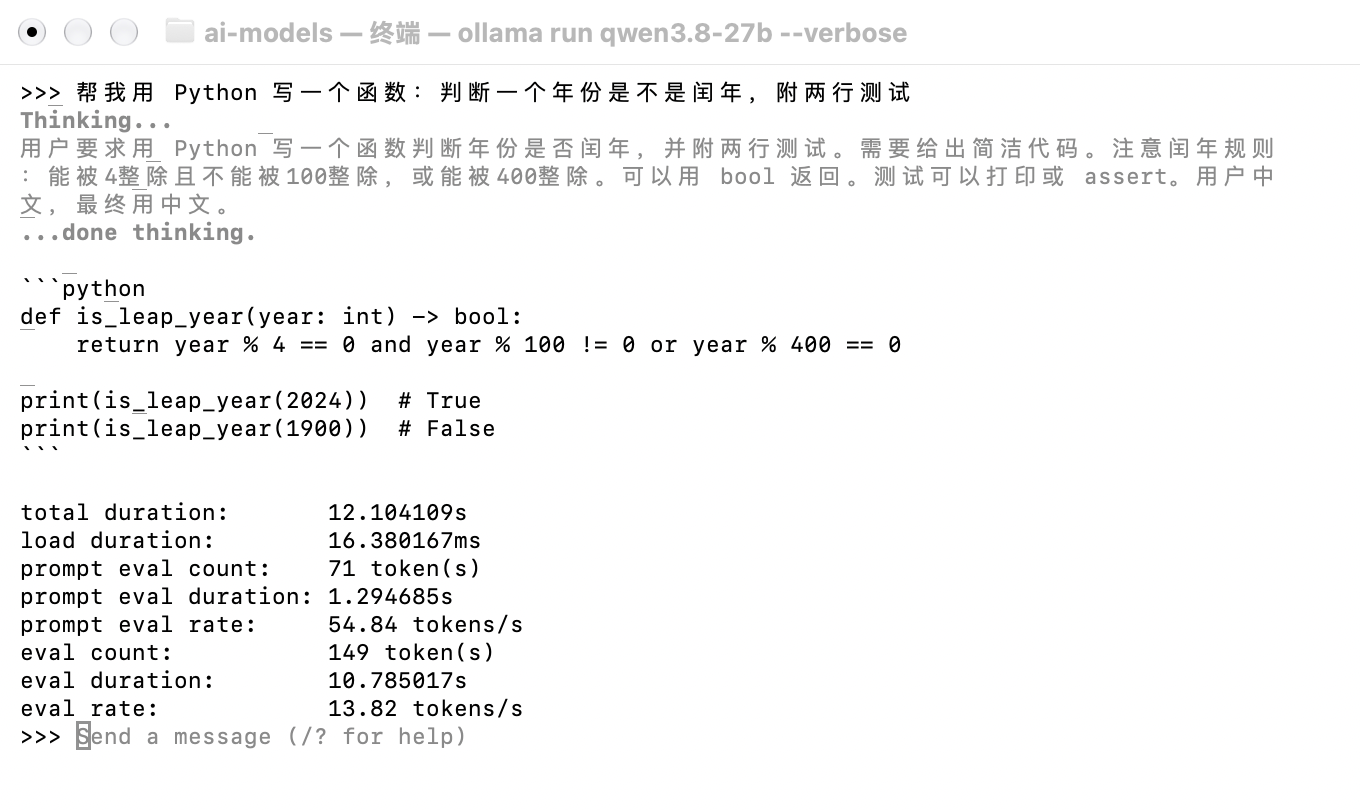 2026-10-03 历史截图:本机当时的 Qwen3.8 Ollama 对话示例
4. 上下文别一味调大
上下文是模型一次能够参考的文字量。长文档或多轮对话会用到更多上下文,但调大也会增加内存占用。先用 Ollama 应用设置里的上下文滑块调整,再通过 ollama ps 看实际分配值;Ollama 服务器也支持用 OLLAMA_CONTEXT_LENGTH 设置运行上下文。设置方式请以当前版本的官方文档为准。
这台 Mac 自动分配到 262,144 上下文时,Q4 运行约占 34GB,Q8 约占 46GB。若你的电脑内存更小,先缩短上下文并关闭不需要的应用;不要把这台 64GB 机器的数据当作 32GB 设备也能稳定运行的保证。
常见问题
ollama create 提示找不到文件:先运行 pwd 和 ls,确认当前目录同时有 Modelfile.q4 与对应 GGUF 文件。检查 FROM ./... 后面的名字、大小写和扩展名是否完全一致。
下载中断:如果仓库支持断点续传,重新运行带 -C - 的 curl 命令;也可回仓库页面使用它当前提供的下载方式。下载后先核对文件是否完整,再导入。
导入成功但回答异常:先用短问题确认模型能正常回复,再核对量化版本、文件来源和 Ollama 版本。社区 GGUF 由第三方转换,格式兼容性和模板设置可能随版本变化。
想让模型看图:本文只讲文本 GGUF 的导入。视觉版本通常还需要与模型匹配的视觉文件和配置,步骤见《让本地 Qwen3.8-27B 看图》。
用它接什么活
如果你为客户提供本地模型安装服务,把电脑型号、内存、硬盘空间、模型来源和授权信息写进交付清单。先在客户确认的样例上测试,再说明本地模型的速度和回答质量不等同于云端服务;不要承诺“完全不出网”,除非你也检查了客户端、插件和网络配置。
工具清单
| 工具 | 用途 | 入口 |
|---|---|---|
| Ollama | 在本机导入和运行模型 | 官方下载页;软件免费 |
| Qwen3.8-27B 官方模型卡 | 查看原始权重、模型说明和基础许可 | Hugging Face 官方 Qwen 组织 |
| Qwen3.8-27B GGUF 社区仓库 | 下载 Ollama 可导入的量化文件 | 文件和授权信息以仓库当前页面为准 |
| Ollama GGUF 导入文档 | 核对 Modelfile 和 ollama create 用法 |
Ollama 官方文档 |
接下来可以做什么
- 让本地 Qwen3.8-27B 看图:继续配置与模型匹配的视觉文件。
- Ollama 本地模型怎么选?:对比不同体量的模型,并用附带脚本做自己的小样测试。