
打开 AI 聊天页面,你可能先看到产品名字,再看到模型选择;输入一句要求后,又在教程里遇到提示词、上下文和 Token。这些词分别描述你用的服务、参与处理的模型、交给它的要求,以及它本次能参考的信息。沿着一条读书会通知看一遍,就能把它们对上位置。
 虚构的青禾 AI 界面:产品提供账号、历史记录和输入入口,示例模型 A 参与处理输入。教学示意,不对应真实产品。
阅读约需 10 分钟,不要求编程知识。你可以先看示例,再在已经能使用的文字对话产品中练习;账号、功能和费用按所选产品确认。下面的通知材料全部虚构,真实回答来自百炼接口,界面图用于讲解概念。
产品是你使用的工具或服务 模型参与处理输入
在图中的“青禾 AI”里,你登录账号、找到历史聊天、输入文字,也可以看到文件上传和模型选择。这些入口和功能由产品提供。“示例模型 A”表示当前选择的模型,它接收本次交给它的信息,生成回答。
模型可以理解为经过训练、用来处理输入的计算系统。常见的文字生成模型从数据中学习语言规律,再结合本轮可用信息生成文字。Google 的语言模型入门课程介绍了语言模型如何根据文字中的规律产生预测,用于生成、翻译和总结等任务。
青禾 AI、示例模型 A 和示例模型 B 都是教学用的名字,没有对应的官网、账号或收费服务。
先记住这两个问题:我在用哪个产品,当前由哪个模型处理。 一个产品可以提供多个模型供选择,也可以自动选择模型;同一个模型可以被不同产品接入。实际使用时,界面未必显示完整的模型名称或版本。
| 你看到的内容 | 属于哪个层面 | 在示意图里对应什么 |
|---|---|---|
| 服务名称、账号、历史聊天 | 产品 | 青禾 AI |
| 模型名称或选择项 | 模型 | 示例模型 A / B |
| 你输入的任务与材料 | 输入提示 | 写通知的要求和活动事实 |
| 生成的通知 | 输出 | 模型返回、产品显示的文字 |
产品的能力还包括它配备的功能。例如,联网找资料需要相应的搜索功能,上传文件需要产品读取文件并把相关内容交给模型。仅知道模型名称,不能据此判断某个入口能否完成这些操作。
在实际示例中,我们使用的是阿里云百炼提供的模型接口服务,模型名是 qwen3.8-max。百炼按官方接口规则计费,入口见阿里云百炼官方介绍。接口的使用方式可以先看上一篇,这里不用编写程序。
提示词是交给 AI 的要求和材料
提示词也常写作 Prompt。对普通文字对话来说,你输入的任务、背景材料和输出要求,都可以组成提示词。它可以是一句短话,也可以是一段完整说明。
下面是第一轮实际发送的输入,可直接复制练习:
以下是虚构教学活动的资料,不对应真实活动。
活动:青禾社区读书会
时间:10月24日14:00–15:00,共60分钟
地点:社区二楼活动室
人数:最多20人
报名截止:10月22日18:00
准备:带一本愿意分享的书
报名链接、联系人、电话、收费信息:未提供

请写一条简短通知,保留上面的活动信息。只使用提供的事实,不增加活动安排;未提供的信息列为待确认。
把它拆开看,能认出三部分:
| 部分 | 这条输入中的内容 | 帮助 AI 确认什么 |
|---|---|---|
| 任务 | 写一条简短通知 | 要完成的动作 |
| 已知材料 | 时间、地点、人数、截止时间、准备事项 | 可以使用的事实 |
| 输出要求 | 保留信息,不增加安排,缺项列为待确认 | 怎样组织结果、怎样处理缺失 |
你不必每次套很长的模板。先把要做的事和关键材料说清楚,再补上对格式、长度或语气的要求。角色设定可以帮助描述风格,例如“按社区活动通知的语气写”;活动地点、报名方式等事实仍然要由你提供或核实。
第一轮回答列出了活动时间、地点、人数、报名截止和准备事项,并将报名链接、联系人、联系电话及收费信息列为待确认。你看到的这段回答,属于输出。它的措辞可以变化,事实需要回到输入核对。
上下文是模型本次可以参考的信息
收到第一条通知后,在同一段对话里继续提出:
语气亲切一些,保留所有时间和地点。这句话没有重写活动名称和日期。模型要改好通知,就需要参考前面的材料和回答。上下文指本次处理时可用的信息。 在这个例子里,它包括第一轮输入、第一轮回答,以及新的修改要求。
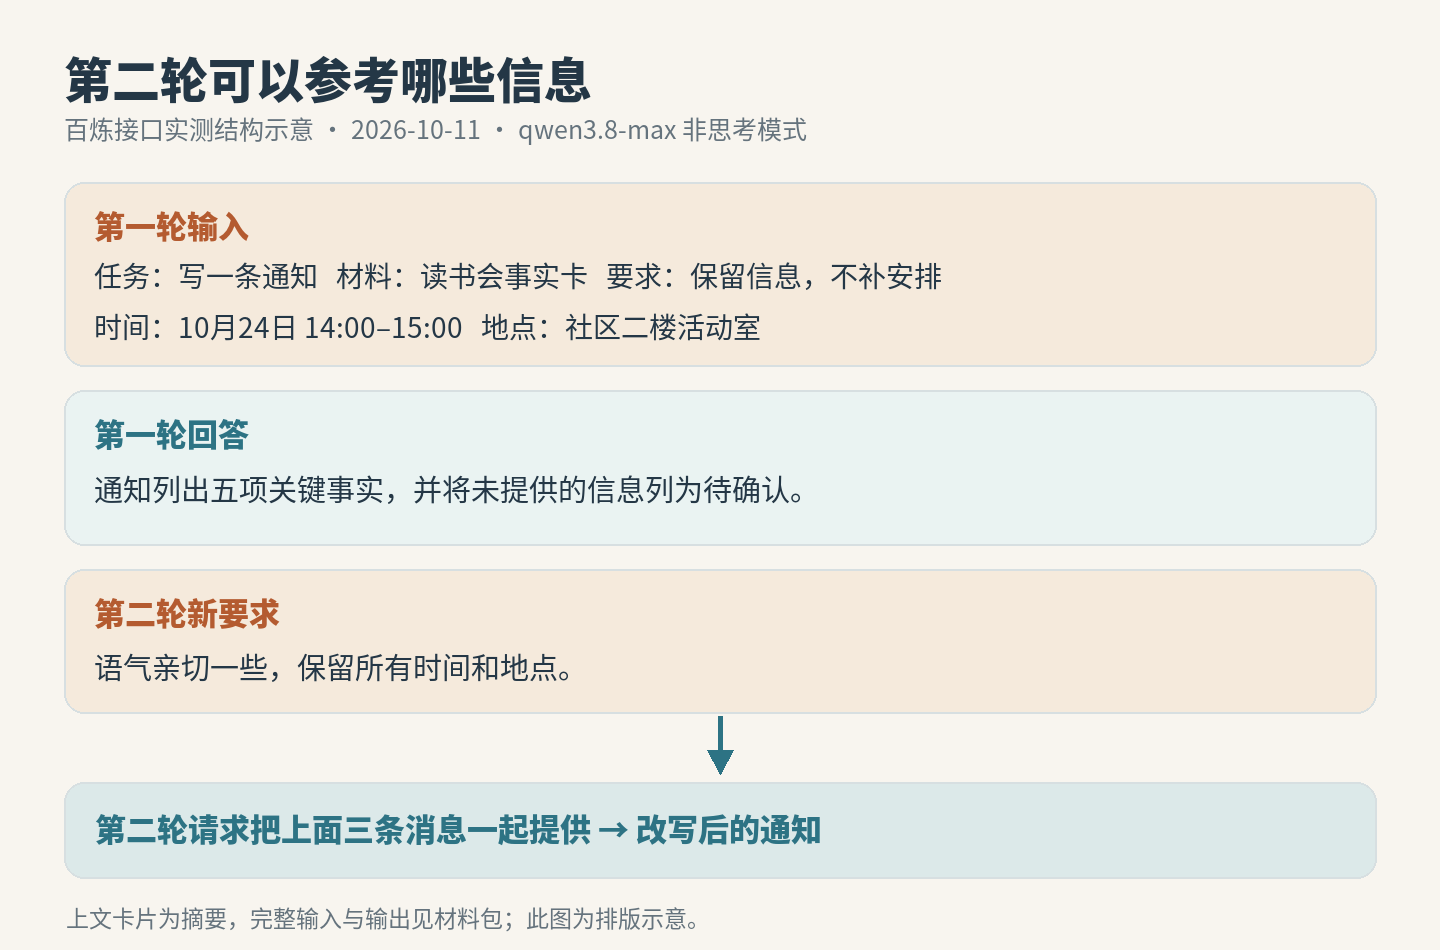 第一轮发送任务与事实,第二轮把前两条消息连同修改要求交给模型。图为实测请求结构的排版示意,未显示完整输出。
第二轮实际回答的开头变成了:
🌱 青禾社区读书会,等你来哦!
亲爱的邻居们:
咱们的“青禾社区读书会”要开始啦!诚邀爱书的你一起来坐坐、聊聊~
后面的列表保留了 10 月 24 日 14:00–15:00、社区二楼活动室、最多 20 人、10 月 22 日 18:00 截止,以及带一本愿意分享的书。语气已经变了,关键事实仍与原材料一致。
它还补了一句“确认后第一时间告诉大家”。这是新增的承诺,原材料没有约定。采用通知前,要决定是否能兑现,或删去这句话。提示词提出了限制,回答仍然需要检查。
在百炼这类聊天接口中,程序要把历史消息随请求传入,才能让模型参考前文。本次第二轮明确传入了上述三条消息。使用 App 或网页时,通常由产品在背后组织输入,你未必能看到完整请求。
产品也可能把规则、相关文件内容、搜索结果或工具返回的信息放入本次上下文。上传成功只说明文件已交给产品;本轮实际选用了哪些段落,还要看产品如何处理。
模型在训练中学到的知识,与本次提供的上下文也要分开看。把活动资料放进对话,是让它在这次处理时参考资料,不能据此认为模型已经通过训练永久学会了这场活动的安排。
界面保留历史 不代表每轮都完整读到历史
聊天记录可以保存很多条,模型一次能处理的信息却有长度限制。产品可能选择近期消息、压缩旧内容,或检索与当前问题相关的片段。百炼的上下文管理说明介绍了截断、摘要和召回这些方法。
因此,“我还能翻到那条旧消息”只能说明记录仍可查看。它不能证明那条消息全文进入了模型这一轮的输入。即使信息已经进入上下文,模型也可能漏用或理解有误,重要内容仍要核对。
如果回答漏掉了早先的条件,可以重新提供关键事实,再要求它对照检查。换任务或开新对话时,把需要沿用的资料和约束一起带过去。
新对话缺少前文 记忆功能需要另外核对
为了观察缺少原文时的表现,我们又做了一次独立请求。模型和设置保持一致,只发送刚才那句修改要求:
语气亲切一些,保留所有时间和地点。这次没有附带活动材料或之前的回答,返回的第一句是:
亲爱的,我注意到你好像忘记把需要修改的原文发给我啦~ 😊
随后它请我们把文字发过去。它没有给出读书会通知中的时间和地点。这里缺少的是待改写的原文,继续提供材料即可。
| 同一句要求怎么发送 | 这次请求包含的信息 | 实际表现 |
|---|---|---|
| 带上前文 | 第一轮材料、第一轮回答、修改要求 | 改写语气,五项关键事实保留 |
| 独立发送 | 只有修改要求 | 请补充需要修改的原文 |
这个对照由接口控制输入,没有启用产品的跨对话记忆。它展示了这三次请求的结果,不能据此断言所有产品的新对话都会这样回答。
有些产品提供记忆功能,可以在新对话里参考过去的聊天或保存的信息。例如,Gemini 官方记忆说明列出了使用条件与开关,适用账号和功能范围也有限制。能否引用其他对话,要按你使用的产品和设置核对。
可以把三者分别理解为:历史记录保存你们聊过什么;本轮上下文提供这次可用的信息;跨对话记忆让产品按其规则引用过去的信息。它们的范围可能重叠,也可能不同。记忆功能不能保证旧聊天中的每个细节都被保留或正确引用。
Token 是处理信息的单位 字数不能固定换算
模型处理文字时,会先按照规则拆成小片段。这些单位叫 Token,拆分过程常称为分词或 Token 化。一个 Token 可能对应一个字符、一个完整词,或词的一部分;具体切分取决于模型使用的分词规则。Google 官方 Token 说明给出了这些基本含义。
中文、英文、数字、标点和表情的组合,会影响切分结果。不要固定地用“一个 Token 等于几个汉字”换算。需要准确数量时,使用对应模型的计数工具,或查看服务返回的用量。
支持多模态的模型还会处理图片、音频或视频,相应输入可能编码或换算成 Token。它们的数量与格式、尺寸、时长及服务规则有关,不能按文字字数估计。Google 的说明也介绍了非文字输入的计数。
同一句短要求 带上前文后输入会变长
下面是 2026 年 10 月 11 日百炼 qwen3.8-max 非思考模式的实际用量。三次请求均返回 HTTP 200,回答正常结束。
| 请求 | 输入 Token | 输出 Token | 合计 Token |
|---|---|---|---|
| 第一轮写通知 | 133 | 134 | 267 |
| 第二轮带前文改写 | 290 | 153 | 443 |
| 独立请求,无前文 | 21 | 80 | 101 |
数字直接取自接口的 usage 字段。根据百炼官方接口定义,prompt_tokens 是输入用量,completion_tokens 是输出用量,total_tokens 是两者之和。
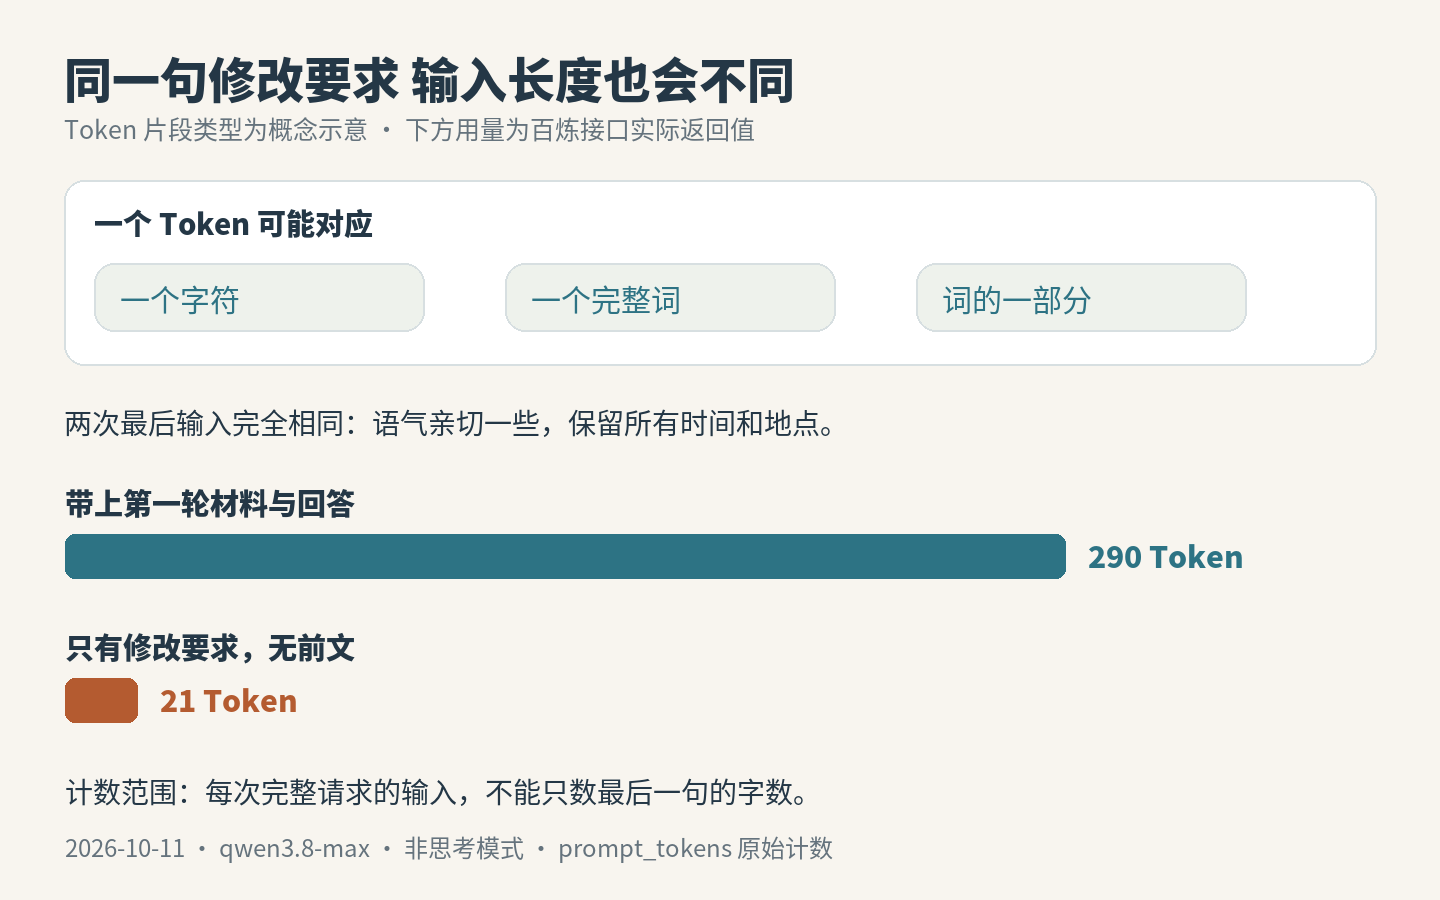 Token 的片段类型为概念示意;下方 290 和 21 是同一句修改要求在不同请求结构中的实际输入用量,包含各请求提供的信息。
第二轮虽然只新输入了一句短话,请求还携带了第一轮材料和回答,所以本次输入计数包含前文。输入用量不能只看你最后一次打了多少字;这张表也不是累计聊天字数,更不是汉字与 Token 的换算公式。
三次请求的原始输入、回答、用量和核对记录都在示例材料包中。表格说明这组实际请求的计数,不用于评价模型准确率或估算其他产品的费用。
输入 输出和上下文容量分别看什么
继续用读书会通知来对照:
| 名称 | 读书会例子里的含义 | 遇到限制时先检查什么 |
|---|---|---|
| 输入 | 本次提供的材料、历史消息和要求等信息 | 有哪些内容被送入、是否超过输入上限 |
| 输出 | 模型这次生成的通知或回复 | 是否回答完整、是否受到输出长度限制 |
| 上下文窗口 | 模型一次能够处理的信息容量 | 该模型及入口怎样计算输入、输出等内容 |
| 单次最大输出长度 | 一次生成所允许的输出上限 | 模型上限、产品限制和本次参数设置 |
介绍中写“支持长上下文”,不意味着它一次就能写出同样长度的文章。上下文容量和最大输出长度需要分别核对;输入与输出是否共同占用某个总容量,也应看对应模型的官方定义。开启思考或使用工具后,计数还可能包含其他部分。
接口可以限制生成长度,达到上限时可能提前停止。百炼的长度参数说明就区分了相关限制。本次三个短例子都正常结束,没有触发长材料超限或输出截断。
处理长文件时,先确认产品支持的文件大小和模型限制。如果材料过长,可以按章节处理,并提供一份统一的事实与任务清单;最后再汇总和核对。分段时要保留彼此相关的条件,例如活动开始时间、总时长和报名截止,避免每一段都缺少必要背景。
用一分钟检查自己是否分清了
回到开头的界面图,找到产品名称、模型名称、你发送的提示词和生成的回答。然后判断下面三句话:
- 聊天记录还在,所以每次回答都能完整看到所有旧消息。
- 第二轮只输入了一句短话,所以输入 Token 只计算这句话。
- 模型支持很长的上下文,所以一次也能生成同样长度的回答。
参考答案:产品是青禾 AI,模型是示例模型 A;任务与活动材料属于输入提示,通知属于输出。三句话都不能直接成立:要分别确认本轮实际提供了哪些信息、完整输入的计数,以及单次输出上限。
练习时,先把完整事实交给 AI,再沿着同一段对话修改。开新对话需要沿用旧内容时,重新提供原文和关键条件。看到模型或 Token 的名称,先问它描述的是处理能力、信息范围还是用量,就更容易读懂后面的教程。
需要回顾能力与核对方法,可以看AI 是什么,能做什么,为什么也会答错。想分清网页、接口和本地运行,可以看AI 的几种使用方式。继续阅读《聊天 搜索 思考 看图和上传文件这些功能怎么理解》,费用可以看《AI 为什么收费,会员 额度 积分和 API 费用怎么看》;参数量、量化和模型文件格式放到本地模型课程中学习。
正文图为教学示意或实测数据排版,封面背景由 AI 生成、标题另行排版。界面中的产品和模型名称为虚构;跨对话记忆按官方资料介绍,本次未测试具体产品的记忆开关或长上下文行为。