
如果你每天要给客服消息分组、给商品评论打分,OpenJev 可以把这些判断放到自己的 Mac 上运行。本文用 M1 Max、64GB 内存跑通了 OpenJev 0.5.0 和 DiffusionGemma 26B-A4B 4-bit 模型:8 条虚构中文样例都符合预设标签,服务启动后第一条请求约 3.11 秒,接下来的请求约 0.35–0.72 秒。这个小样只说明流程可用,不能当作普遍准确率或速度承诺。
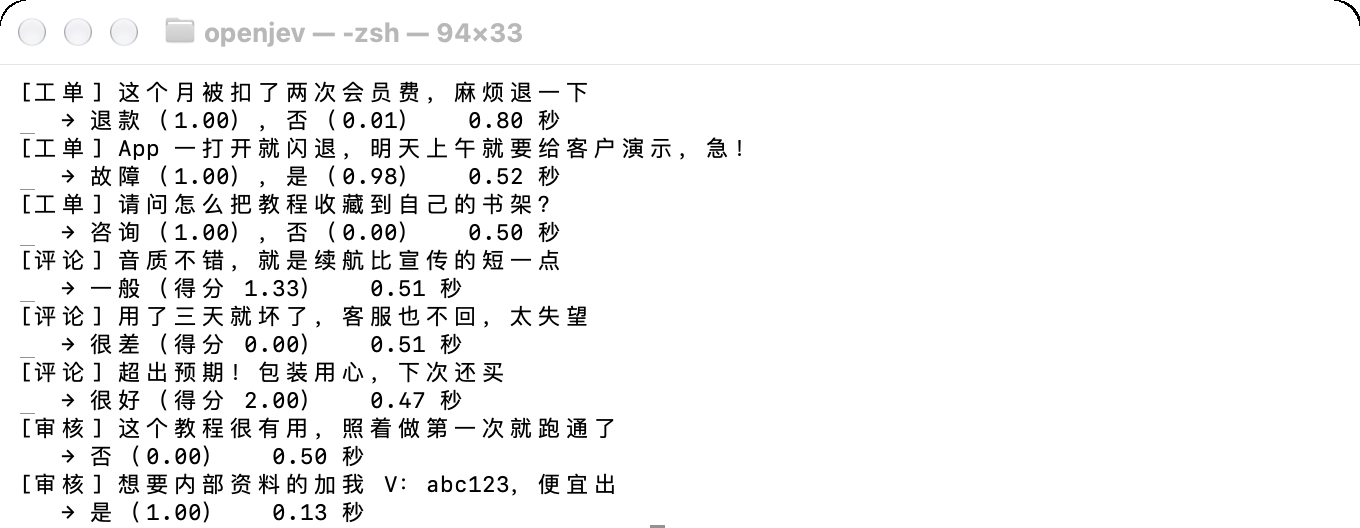 OpenJev 0.5.0 在 8 条虚构中文工单、评论和广告样例上的终端输出;截图为早前一次运行,耗时会随设备和缓存变化
文章里的演示脚本可以直接下载 OpenJev Mac 中文样例工具包。ZIP 中的 openjev_demo.py 就是脚本本体,旁边 README 写了运行条件;脚本只用 Python 标准库访问本机服务。
适合什么电脑
OpenJev 是社区维护的开源项目,使用 DiffusionGemma 做是非判断、选项分类和分档评分;它与 TypeSafe 的 Jev 项目相互独立,不是官方 Jev,也不保证结果相同。Apple 芯片 Mac 通过 MLX 后端运行,不需要 Docker 或 API Key。
| 需要准备 | 本文实测环境 |
|---|---|
| Apple 芯片 Mac,建议 32GB 或以上统一内存 | M1 Max,64GB |
| 约 16.5GB 模型文件,加上依赖和缓存需更多磁盘空间 | 模型文件已在本机下载 |
| Python 3.10+、uv,首次安装时联网 | Python 3.12、uv |
| 首次下载模型需要约 16.5GB 网络流量 | 本次使用 4-bit MLX 模型 |
模型权重较大,运行时内存也可能高于权重文件大小。官方仓库说明 4-bit 权重加载约需 16GB,服务运行时还需要额外内存;64GB Mac 更宽松。16GB 或 24GB Mac 本文没有实测,不建议只根据“权重约 16.5GB”判断能否运行。
安装源码与依赖需要能访问 GitHub 和所用 Python 包源;下载模型可以使用上面的 ModelScope 镜像。16.5GB 模型的下载时间取决于网络速度。
安装 OpenJev
下面固定到本文实测的代码版本,避免上游更新后结果和命令细节变化。先按《安装 Python 和 uv》准备环境,再在终端运行:
mkdir -p ~/ai-demo
cd ~/ai-demo
git clone https://github.com/razorback16/openjev.git
cd openjev
git checkout dcd20947b5ddad5be4a8f5aed6aa6dd245653823
uv venv --python 3.12 --managed-python
source .venv/bin/activate
uv pip install -e '.[mlx]' modelscope
这里固定的是 OpenJev 0.5.0 的实测提交。上游更新记录截至 2026-10-09 已列出 0.6.0;如果你想用最新版,去掉 git checkout ... 这行并查看项目 README。本文的实测数字只对应 0.5.0。
下载模型
MLX 版 DiffusionGemma 4-bit 模型约 16.5GB。模型卡和 ModelScope 镜像都提供模型文件,空间不足时先别开始下载:
modelscope download \
  --model mlx-community/diffusiongemma-26B-A4B-it-4bit \
  --local_dir ~/ai-models/diffusiongemma-26B-A4B-it-4bit
本文用 modelscope 命令下载;这一步会把约 16.5GB 文件写入 ~/ai-models/。该模型卡标注 Apache-2.0。下载后,权重可在本机读取;代码和模型初次安装仍需要联网。
启动本机服务
在 OpenJev 项目目录里执行:
source .venv/bin/activate
OPENJEV_BACKEND=mlx \
OPENJEV_MLX_MODEL=~/ai-models/diffusiongemma-26B-A4B-it-4bit \
OPENJEV_MLX_CACHE_LIMIT_GB=4 \
HF_HUB_OFFLINE=1 \
python -m openjev
看到 Uvicorn running on http://127.0.0.1:8080 后,保持这个终端窗口运行。HF_HUB_OFFLINE=1 让模型加载只使用本地缓存;如果文件没有完整下载,启动会失败。OPENJEV_MLX_CACHE_LIMIT_GB=4 限制 MLX 的可复用内存缓存;机器内存较小时,不要同时运行其他大型模型。
另开一个终端窗口,在同一项目目录运行下载包里的样例脚本:
python3 /解压目录/toolkit/openjev_demo.py把 /解压目录/ 换成 ZIP 的实际解压位置。你会看到每条样例的分类、分数和请求耗时。若要用自己的文字,先在脚本中替换样例;不要把含有姓名、电话、订单号或其他隐私的真实工单直接用于练习。
怎么看判断结果
OpenJev 的接口有三类常见问题:
| 类型 | 返回含义 | 例子 |
|---|---|---|
noul |
是的概率,0 到 1 | 是否需要一小时内回复 |
choice |
从你给的类别中选一项,并给出类别概率 | 退款、故障、咨询 |
score |
按顺序排列的等级分数 | 很差、一般、很好 |
样例脚本用退款工单、紧急故障、使用咨询、满意度评论和广告引流文本演示三种提问。我们在当前机器上重跑 8 条虚构样例,8 条都符合预设标签;这不是测试集,也不足以说明它在真实客服数据上的准确率。部署前请准备自己有人工标签的样本,统计每类的误判,再决定哪些结果可以自动分流、哪些必须转人工。
常见问题
启动日志里出现 PyTorch was not found? 本文选择的是 MLX 后端,这条提示不等于模型启动失败;确认后面是否出现 Uvicorn running...,再调用接口。
运行一段时间后内存增加? 本文启动命令限制 MLX 缓存为 4GB。模型本身和运行时工作区仍会占内存,发现系统内存紧张时先停止服务,不要只依赖缓存上限。
OpenJev 和 Jev 是同一个模型吗? 不是。OpenJev 是独立社区项目,使用 DiffusionGemma;接口设计兼容 Jev 的 SystemOne 请求格式,但模型、能力和判断效果可能不同。OpenJev 0.5.0 不接受带具体 Jev 版本号的模型名,调用时使用 openjev-latest。
能用来自动封号或自动拒绝退款吗? 不建议直接这么做。小样例结果不能代表真实业务;涉及钱、账号、申诉或广告处罚的判断,应先设人工复核,并按自己的标注数据验证。
拿它挣钱
可以为小团队交付一套本地客服文本分流原型:安装环境、接入工单导出、用客户标注数据评估,再把不确定项留给人工。报价按数据整理、部署维护和复核流程设计分别计算;模型开源不代表部署、运维和准确率承诺没有成本。先让客户确认测试数据可以在这台设备上处理,再开始导入。
工具入口
- OpenJev 源码与最新版安装说明:查看上游当前 README 和更新记录。
- DiffusionGemma 4-bit MLX 模型卡:查看权重大小、格式和许可证。
- ModelScope 模型镜像:通过 ModelScope 下载本文使用的模型。
- OpenJev Mac 中文样例工具包:脚本、README 和虚构样例。