
15 秒的带货短视频,难的不是「写得好不好听」,而是三件事:能不能在 15 秒里读完、每句话有没有依据、拍的人看不看得懂。
下面用豆包写脚本、出分镜参考图(这次没看到扣费),再讲怎么检查口播读不读得完。这是豆包按一句话画的 4 个镜头:
 豆包画的分镜参考图:冷天拿起杯子、转动展示、杯盖当杯子倒水、往镜头前推(画面是 AI 画的拍摄参考,不是商品实拍)
商品是本系列一直用的墨绿保温杯(AI 生成的演示素材),参数沿用《用 AI 写商品标题和卖点不踩红线》里的事实清单。
你需要准备
- 商品的事实清单:只写能拿出证据的参数和测试数据;
- 一张商品图(白底图就行),用来出分镜参考图;
- 豆包账号,网页 doubao.com 或手机 App;
- 手机秒表。
第一步:让豆包按规则写脚本
最关键的是第 3 条:口播每秒最多 3 个字,数字按读法算。这是我们实测出来的,原因见后面。复制下面这段,换成你的商品:
你是抖音、淘宝短视频的带货编导。给下面的商品写一条 15 秒的竖屏带货短视频脚本。

商品:墨绿保温杯(类目:日用品)
事实清单(口播和字幕只能用这里面的内容):
- 容量 500ml
- 内胆 316 不锈钢,外壳 304 不锈钢
- 真空双层结构
- 注入 95℃ 热水,6 小时后约 62℃(店家自测)
- 杯盖可以当杯子倒水喝
- 重量约 320g
- 颜色:墨绿

要求:
1. 分 4~5 个镜头,时间连续,从 0 秒到 15 秒;
2. 前 3 秒是钩子:用一个具体的使用场景或问题抓住人,不要用「家人们」「宝子们」这类口头禅开场;
3. 口播按实际读出来的字数算(数字要按读法算,例如「95度」是「九十五度」4 个字),每秒最多 3 个字:3 秒的镜头不超过 9 个字,4 秒的镜头不超过 12 个字,全片不超过 42 个字;
4. 每句口播必须能在事实清单里找到依据,没有依据的感受和效果不要写;
5. 字幕是屏幕上的大字,每条不超过 8 个字;
6. 画面写清楚拍什么、怎么拍(景别、动作),只拍商品和手,不出现人脸;
7. 最后一个镜头引导下单,但不写价格、不写「最后一天」「限时」这类没有依据的促销;
8. 不用绝对化用语。

用表格输出,列是:时间、画面、口播、口播字数(按读法)、字幕、依据。
豆包这次写的:
| 时间 | 画面 | 口播 | 它数的字数 | 字幕 |
|---|---|---|---|---|
| 0-3 秒 | 特写,手拿起保温杯,冷风里捧杯 | 热水很快凉了? | 6 | 热水易凉? |
| 3-7 秒 | 中近景,手转动杯身展示外观,开盖 | 墨绿 500 毫升保温杯 | 8 | 500ml 墨绿杯 |
| 7-11 秒 | 特写,展示杯盖倒水 | 316 内胆,杯盖当水杯 | 9 | 316 内胆 杯盖可喝 |
| 11-15 秒 | 近景,手托保温杯往镜头前推 | 双层真空,约三百二十克 | 9 | 双层真空 约 320g |
没有编参数,也没有极限词。但有三处要改:
- 字数数错了:「墨绿 500 毫升保温杯」读出来是「墨绿五百毫升保温杯」,9 个字,它数成 8;「316 内胆,杯盖当水杯」至少 10 个字,「316」要是被读成「三百一十六」就是 12 个字;
- 最后一个镜头说要引导下单,口播里却没有,换成「墨绿保温杯,点击下方」这类话;
- 它主动说明了「店家测温数据因字数限制未放入口播」。15 秒放不下的测试条件,放进画面的小字(比如「注入 95℃ 热水 6 小时后约 62℃ · 店家自测」),不能只写「保温」两个字。
第二步:读出来,掐表
AI 数字数不准,估算也不准。最可靠的办法:每个镜头的口播,用你平时说话的速度读一遍,拿手机秒表掐时间。超过镜头时长的,删字,不要加快语速。
我们之前用配音模型把 6 份脚本的口播真的读出来量过,结果是:
- 实际语速只有每秒 3.3~3.7 个字,不是常说的每秒 4~5 个字。按每秒 4 个字写的 6 份脚本,4 份有镜头读不完;
- 数字读出来更长:「95度」读作「九十五度」,「316」被配音读成了「三百一十六」(行业里一般读「三一六」)。所以口播里的数字,干脆直接写成读法:「三一六」「六十二度」。
这是按每秒 4 个字写的一份,听一下镜头切换时口播还没说完:
按每秒 4 个字写的脚本配音:14.7 秒,最后两个镜头读不完
改成每秒最多 3 个字后,重写的口播 10 秒左右就读完了,每句都在自己的镜头里:
按每秒 3 个字重写后的配音:每句在自己的镜头时间点开始
第三步:出一张分镜参考图
给拍摄的人看,比文字描述清楚得多。豆包点「图像生成」,上传商品图,按脚本的画面写:
短视频分镜参考图:用参考图里这个墨绿保温杯,画一张 2×2 四宫格,每格是一个竖屏镜头。左上:特写,一只手在冷风里拿起保温杯;右上:中近景,手转动杯身展示外观;左下:特写,手把杯盖拧下来当杯子倒水;右下:近景,手托着保温杯往镜头前推。只拍手和商品,不要出现人脸,不要写字。杯子的形状、颜色和标志照原图。出来就是文章开头那张图。每格下面的时间、字幕、口播,在聊天里或打印出来手写上就行。
分镜参考图只是拍摄参考,不是商品图:比如左下杯口的螺纹、右下杯盖拧开后的样子,都是 AI 画的。正式视频要用真实商品拍。
拿它挣钱:给店铺写带货脚本
- 谁需要:要做短视频但没有编导的小店;接拍摄单的摄影师;
- 交付什么:2~3 版脚本(表格)+ 每版的分镜参考图 + 一段自己读的口播样音,拍摄的人照着拍就行;
- 怎么报价:去闲鱼、淘宝搜「带货短视频脚本」「分镜脚本」,看同行按条怎么收。
合规提醒:口播里的每个数字都要有依据,测试数据要带上测试条件;视频用了 AI 配音、AI 画面的,发布时按《人工智能生成合成内容标识办法》和平台规则标识。
我们还试了什么
之前我们用同一个提示词对比了云端的 Gemini 3.8 Flash、Gemini 3.1 Pro 和本机的 Qwen3.8-27B,各写 2 次:
| Gemini 3.8 Flash | Gemini 3.1 Pro | Qwen3.8-27B(本机) | |
|---|---|---|---|
| 每次用时 | 8~19 秒 | 38~59 秒 | 34~44 秒 |
| 内容准确 | 两次都没编东西,一次还带上了测试条件 | 准确,有一句没依据的「倒水烫嘴?」 | 写了没依据的「隔热防烫」 |
| 镜头描述 | 具体:温度计显示 62℃、指向购物车 | 具体 | 偏笼统 |
每秒 3 个字的规则,就是那次用本机的 CosyVoice 3(《在 Mac 上部署 Fun-CosyVoice 3》,开源、能克隆自己的声音)逐镜头配音量出来的。按旧规则写的 6 份脚本:
| 脚本 | 口播字数 | 实际读了 | 实际语速 | 读不完的镜头 |
|---|---|---|---|---|
| Gemini 3.8 Flash ① | 46 | 12.6 秒 | 3.7 字/秒 | 0 |
| Gemini 3.8 Flash ② | 54 | 14.7 秒 | 3.7 字/秒 | 2 |
| Gemini 3.1 Pro ① | 50 | 15.3 秒 | 3.3 字/秒 | 2 |
| Gemini 3.1 Pro ② | 50 | 14.5 秒 | 3.4 字/秒 | 1 |
| Qwen3.8-27B ① | 43 | 13.2 秒 | 3.3 字/秒 | 1 |
| Qwen3.8-27B ② | 35 | 10.1 秒 | 3.5 字/秒 | 0 |
也试了 Gemini 的语音合成读同一段口播(整段 10.4 秒)。它会把写在文字前面的「用热情的主播语气读」也读出来,用方括号标签 [excited] 才正常:
Gemini 语音合成(音色 Kore,语气标签 excited):整段 10.4 秒
分镜图当时用 Nano Banana Pro 画,再用脚本把时间、字幕、口播写到格子下面:
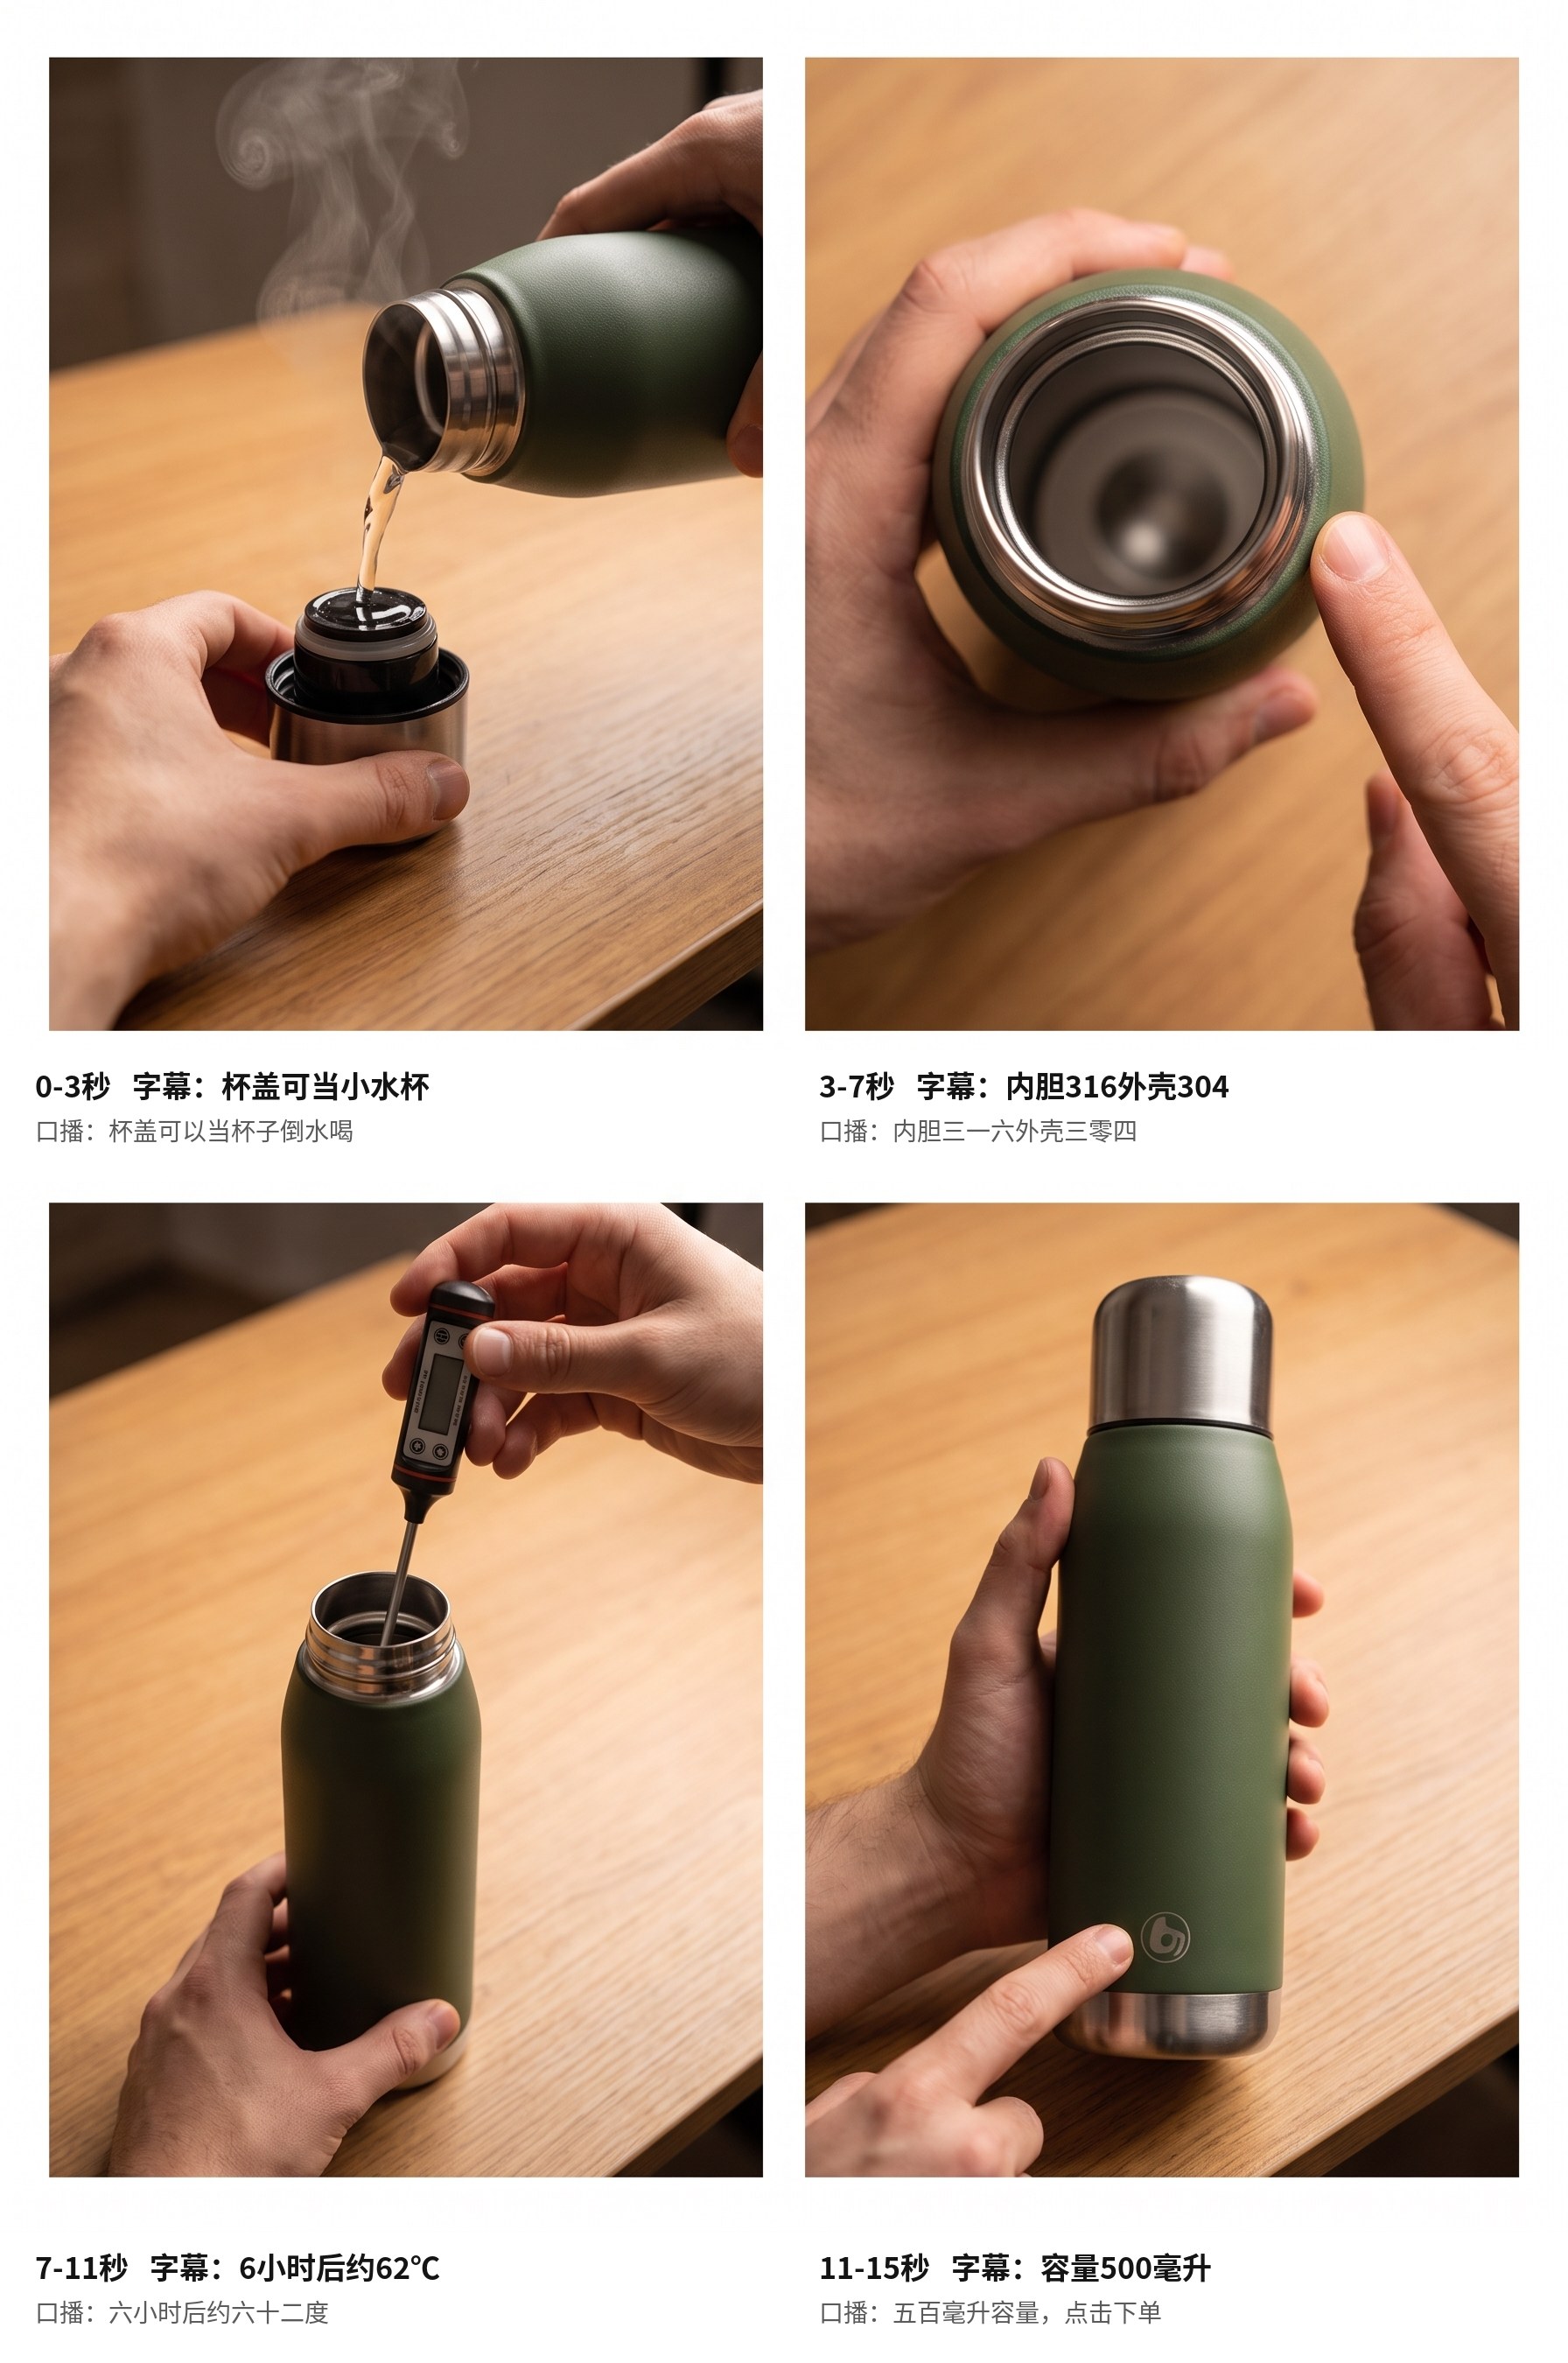 Nano Banana Pro 画的分镜板,每格下面是时间、字幕和口播
想用店主或主播自己的声音配音,用 CosyVoice;用别人的声音必须经过本人同意。
常见问题
口播读不完,能不能让配音读快一点?
不建议。读快了听不清,尤其是数字。删字比加速好。
能直接把分镜图做成视频吗?
可以把每个镜头交给图生视频工具(见《一张商品图生成 5 秒主图视频》),但每个镜头都要用真实商品照片做首帧,生成后逐帧检查商品有没有变。
用到的工具
| 工具 | 用来做什么 | 费用 | 去哪用 |
|---|---|---|---|
| 豆包 | 写脚本、画分镜参考图 | 这次没看到扣费 | doubao.com,或手机 App |
| 手机秒表 | 读口播掐时长 | 免费 | 手机自带 |
接下来
- 主图视频怎么做:《一张商品图生成 5 秒主图视频》
- 直播讲解稿:《直播讲解稿和答疑卡》