
你可以把同领域的公开内容记录整理成表格,让文字 AI 提出选题规律,再用脚本核对它说的分组差异。本文用 120 条虚构记录演示整套流程,并附上可下载的 Python 工具包;这些结果只能说明脚本如何工作,不能代表真实平台或账号。
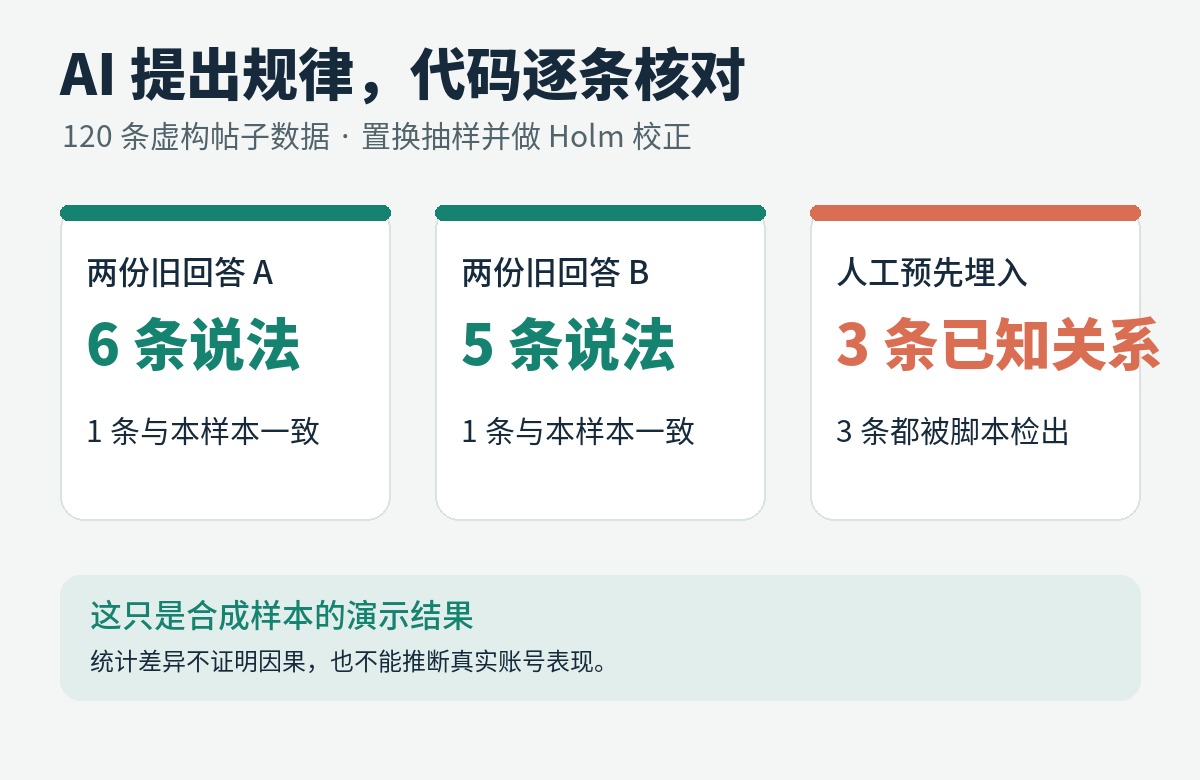 120 条虚构记录经过 AI 提假设和脚本核对的示意结果,不是真实平台数据
先下载选题数据核验工具包。里面有样例 CSV、提示词、历史 AI 回答和离线核验脚本。店铺、帖子、互动数和个人经历都是虚构的练习素材。
| 你需要准备 | 用途 |
|---|---|
| Python 3 | 运行规律核验和标题相似提醒;不需要安装第三方库 |
| 文字 AI 工具 | 根据你提供的表格提出待检验的假设;是否收费按你当前使用的产品和账号为准 |
| 一份自己整理的记录 | 至少包含标题、形式、发布日期、点赞、收藏和评论;尽量来自同一账号和相近时间段 |
第一步:整理一份可比较的记录
挑你熟悉的一个内容领域,把公开帖子中能看到的标题、内容形式、发布日期和互动数记录到 CSV。模板在工具包 examples/notes.csv。真实操作时用你自己的数据替换,不要把作者昵称、私信、联系方式或客户未公开资料放进表格。
尽量比较同一账号、相近发布时间段的内容。点赞和收藏数没有考虑曝光量、粉丝数、投放和内容主题差别,所以它们只能描述这张表里的互动差异,不能直接说明哪类标题会带来更多流量或成交。本文没有登录小红书逐条采集,也没有验证平台界面或当前规则;采集和使用数据时请遵守目标平台当期要求。
第二步:让 AI 提假设,不要让它替数据下结论
打开工具包里的 prompts.md,复制“提出可检验的假设”提示词,把去掉个人信息的 CSV 内容贴给你正在使用的文字 AI。要求它最多提出 6 条,并为每条返回一条能机械分组的规则,例如“标题包含某个关键词”“标题长度超过 10 个字”或“图文形式”。把返回内容保存成 JSON 文件。
每条规律都要包含 claim、metric、direction 和 rule。模型如果给出“因为周一上班忙,所以周一更容易爆”这类因果解释,先把它改成“周一发布的样本点赞中位数是否更高”这样的待检验问题。故事听起来合理,不等于表格支持它。
第三步:用脚本核对这些分组
解压工具包,在终端进入该文件夹。先做自检,再用样例数据运行:
python3 s063_tools.py self-test
python3 s063_tools.py audit examples/notes.csv examples/ai_response_a.json
核验自己的文件时,把最后一条命令换成你的 CSV 和 AI 返回 JSON:
python3 s063_tools.py audit my_posts.csv my_hypotheses.json脚本按 AI 给出的规则分组,比较两组互动数的中位数,并进行置换抽样。它对同一轮提出的多条假设使用 Holm 方法调整 p 值,降低同时测试很多说法时偶然出现“显著结果”的机会。每组少于 5 篇时会提示样本不足;5 篇只是脚本的最低提醒线,不是得出可靠结论的样本量标准。
在这份虚构表中,两份 2026-10-06 的旧模型回答分别提出了 6 条和 5 条说法。用现在工具包里的检验方法重算后,回答 A 中“带情绪化故事前缀的标题,评论中位数更高”与样本一致(35 对 11,Holm p=0.003);回答 B 中“标题含具体工作场景,点赞中位数更高”与样本一致(418 对 243,Holm p=0.027)。其余说法没有通过这次筛查。
这 120 条数据是脚本按预先设定的三条关系生成的。用 examples/planted_rules.json 核对时,三条预设关系都在样本中出现,另一个混杂说法没有通过。AI 的回答只各碰巧识别到其中一条。整套数据是为了让你能对答案而构造的,不是对真实创作者的调研。
p 值不是“规律为真的概率”,也不代表效果有多大。美国统计学会提醒,p 值应结合研究设计、数据质量和其他证据解释,不能单独作为结论。这里的抽样检验只是给一份小表做探索性筛查;真实帖子不是随机抽取,账号大小、发布时间和曝光量等因素也可能混在一起。即使通过,仍不能证明因果或推断其他账号。统计学会的声明有更完整的说明。
第四步:检查候选标题,再补上真实经历
先把 AI 给出的标题存成包含 topics 列表的 JSON,再运行:
python3 s063_tools.py topics my_posts.csv my_topics.json脚本会标出与样本标题相似度达到 0.8 的候选项,以及复用了样本标题前缀的候选项。0.8 是提醒线,不是抄袭判定;不同题材可能需要调整。它也无法判断故事是否真实。
写自己的新选题时,把工具包 examples/mine_fictional.json 替换为你亲自做过、愿意公开的经历,只把核对过的观察交给 AI。这个 JSON 的人物和经历全是虚构示范,不能原样当成个人经验。模型给出的标题还要自己逐条看:事实有没有发生、时间和数字是否准确、有没有和别人标题过于接近。
把它做成一项内容服务
你可以为小店或创作者整理一段时间的公开内容数据,交付原始记录、值得继续验证的选题假设和经过本人确认的标题草稿。先约定数据范围、是否包含竞品、哪些资料不能上传、由谁确认个人经历和最终文案。报价按采集、清洗、分析和复核的实际工作量,再查看本地同类服务,不承诺爆款、流量或销量。
常见问题
核验通过,就能照着规律发吗?
不能。脚本只告诉你这份表里两组互动数出现了差异迹象。换账号、换时间段或换指标,结果可能不同;先把它当作下一轮内容实验的候选方向。
标题相似度 0.8 是抄袭吗?
不是。它只是字符串相似提醒,不能代替版权判断,也不能识别改写后仍高度借用的表达。人工看原文和具体语境。
脚本会自动判断经历是不是编的?
不会。它只比较标题文本和表格里的经历前缀。经历真假、数字来源和是否有权公开,必须由作者核对。
完整脚本和样例数据在哪里?
在本文开头的选题数据核验工具包里。README 说明 CSV 格式、四种规则、自检和运行命令。
工具清单
- Python 3:运行本地核验脚本,只用标准库。
- 选题数据核验工具包:包含提示词、虚构数据、历史 AI 回答和自检脚本。
- Python 3 官方文档:查看 Python 安装与命令行说明。
接下来可以看一稿多发,把核实过的素材改写成多种内容形式;也可以看让 AI 学会你的文风,用自己的旧文章做表达参考。