读论文、行业报告或政策文件时,最费时间的常常不是写一段摘要,而是回头找“这句话到底出自哪里”。你可以让本机 Qwen 帮你把研究问题、方法、结果和限制整理成一张证据卡,每个结论都带章节或表号。本文用一篇公开论文做演示,并保留原文里一处 41.8 和 41.0 的数字冲突,看看模型能不能把疑点交还给你复核。
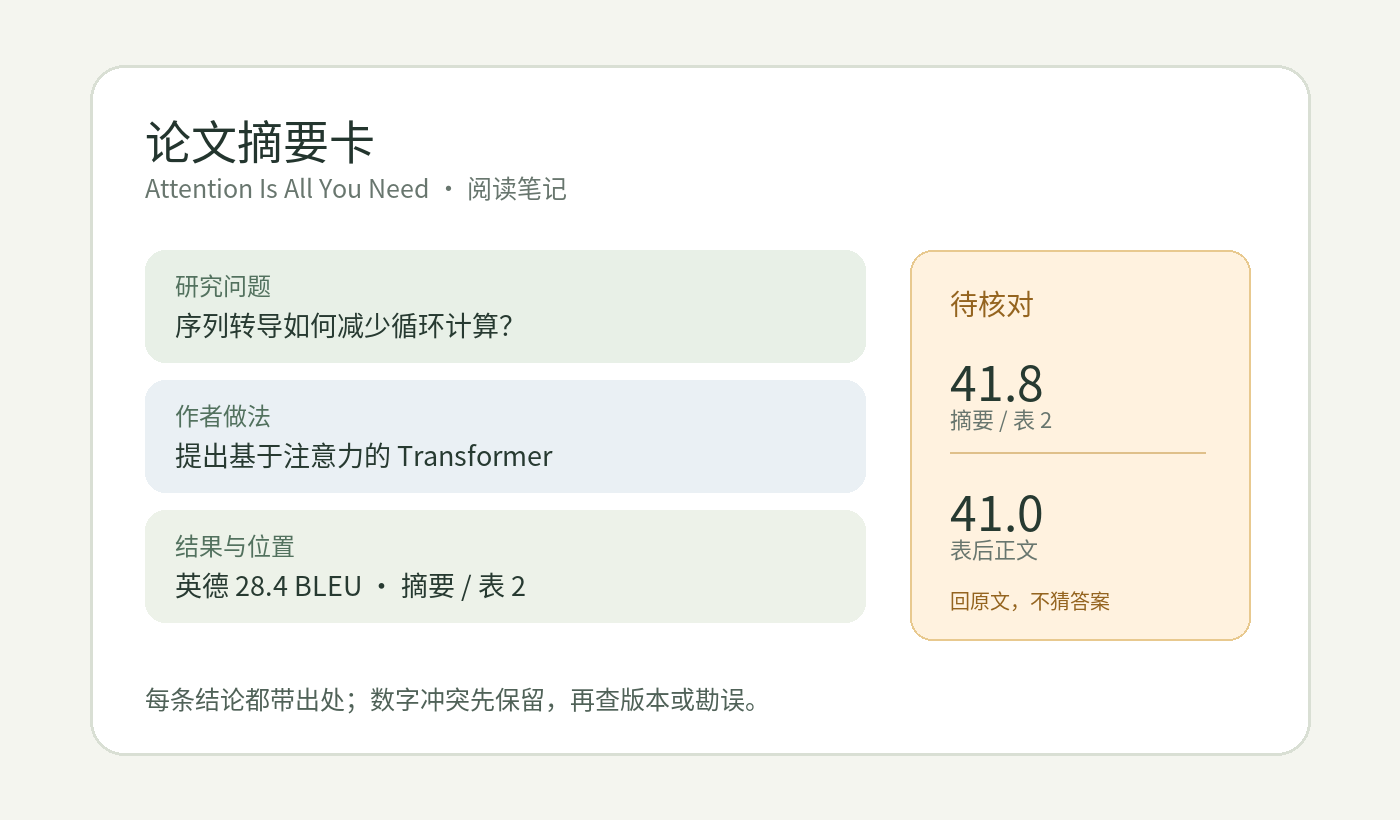 论文摘要卡示意图:结论与来源位置并列,并把数字冲突标为待核对
准备好论文和本机模型
| 项目 | 需要准备 |
|---|---|
| 电脑 | 本例在 M1 Max、64GB 内存的 Mac 上运行;较小配置未验证 |
| 模型 | Ollama 本机运行 Qwen3.8-27B;模型文件约 18GB,另留运行空间 |
| 材料 | 论文标题、作者、年份、DOI 或 arXiv 编号,以及你核对过的摘录和章节位置 |
| 时间 | 本例模型整理用时约 50 秒;人工读原文和复核另计 |
| 费用 | 本地运行不按次付费;需自行准备电脑和磁盘空间 |
Ollama 是本机运行大语言模型的工具,Qwen3.8-27B 是 Qwen 系列模型。本例模型卡标注 Apache 2.0,下载约 18GB;以官方页面当前信息为准。查看 Qwen3.8 模型页 · 查看官方模型卡。如果尚未安装,可先看本机运行 Qwen3.8-27B和安装 Ollama。
第一步:先找到可靠原文
先从期刊、会议、政府部门或研究机构的正式页面找原文,记下标题、作者、年份、版本号和 DOI / arXiv 编号。网页摘要适合快速了解主题,但涉及数字、方法和限制时,要回到正文、表格和脚注。
本例使用 Vaswani 等人在 2017 年公开的 Attention Is All You Need。打开论文原始页面,再用HTML 全文按章节查证。没有必要把整篇论文一次性塞给模型:可以先选摘要、方法、与你的问题有关的结果表和讨论部分,自己记下章节或表号。
如果手上只有扫描版 PDF,先用可信的 PDF 阅读器搜索文字;扫描件需要 OCR 时,抽查识别结果,尤其是表格、公式、脚注和小数点。本文没有测试 PDF 解析或 OCR,不能把下面的结果理解成模型能独立读准任何论文。
第二步:用固定字段整理,不让模型补常识
在 Ollama 的本机聊天界面里选择 Qwen3.8-27B,或者按官方 Generate API 文档调用模型。把你确认过的来源信息和短摘录贴进去,再附上练习包中的提示词。提示词要求模型写出研究问题、方法、结果、研究范围、原文冲突和不能推出的结论;每条结果都要带位置,不确定就写“材料未说明”。
整理结果时可以用这张卡片:
| 字段 | 记录什么 |
|---|---|
| 研究问题 | 作者想回答什么问题 |
| 做法 | 数据、样本、方法或实验设置 |
| 主要结果 | 数字和结论,并附章节、表号或页码 |
| 适用范围 | 哪类任务、样本和条件下得到结果 |
| 待核对处 | 摘要、正文、表格或版本间的差异 |
| 不能推出 | 这项研究没有证明什么 |
把模型输出逐行和原文对照。作者、年份、版本、数字、单位和章节定位都要自己核实;不要直接引用模型生成的页码,也别把“同时出现”改写成“导致”。
第三步:用一处数字冲突检验摘要卡
这篇论文提出 Transformer,用注意力机制构建序列转导模型。在 WMT 2014 英德翻译任务中,论文报告 Transformer big 得分为 28.4 BLEU。BLEU 是论文使用的翻译评价指标,不等同于准确率。
英法任务则出现了一个适合练习复核的矛盾:论文摘要和第 6.1 节表 2 写 41.8,紧接表格的正文写 41.0。我们把这两个位置都交给本机 Qwen 后,它分别记录了数值和出处,没有擅自选一个;人工回到原文也确认了这处不一致。正确的处理方式是把它标为“待查版本或勘误”,引用前继续核对,而不是猜哪个数字正确。
人工复核后的论文摘要卡示例
练习包里有模型原始输出和人工复核记录。这次输入模型的是我们根据原始页面整理的短笔记,约 337 个输入 token;模型用时约 50 秒,输出 432 个 token。它没有直接读取完整论文,也没有独立发现未提供的冲突。这验证的是“有来源线索时能否整理并保留疑点”,不是全文阅读能力测试。
第四步:把摘要当阅读笔记,不当引用
读完后保留三样东西:原文链接、带位置的证据卡、尚未解决的问题。写报告或论文时,引用仍要回到原文或正式出版版本,按学校、期刊或单位的格式自己核对页码和版本。模型生成的摘要不能替代对原作者论证的理解,也不能代替引用。
若要把论文内容用于公开课程、报告或商业材料,只摘录完成说明所必需的短句,并按适用的版权规则、机构要求和引用规范处理。模型输出也要按你所在学校、期刊或单位的生成式 AI 规定披露;不要把未公开的审稿稿件、个人资料或受保密协议约束的材料上传到未经批准的服务。本例使用本机 Ollama,但本机运行也不改变你对原文和数据的保密义务。
工具和练习包
| 工具 | 用途 | 说明 |
|---|---|---|
| Ollama | 在本机下载并运行模型 | 免费工具;模型文件和运行需要本机磁盘及内存 |
| Qwen3.8-27B | 整理来源笔记,生成摘要卡草稿 | 本机实测约 50 秒;输出仍需逐条复核 |
| arXiv | 查阅论文条目、版本和原文链接 | 论文页面提供版本信息;引用时确认你使用的版本 |
下载论文与报告摘要卡练习包,里面有提示词、模型原始输出、证据复核记录、人工摘要卡和实测说明。它不包含论文 PDF,也不含整篇论文文本。
本次没有测试扫描版 OCR、自动抓取 PDF、批量文献管理或引用格式生成;也没有用模型输出替代正式学术引用。涉及学术写作时,先查所在机构的 AI 使用规则,并对每条结论回到原文复核。