
一句话需求可以作为演示文稿的起点,但还不足以直接交给模型写整套汇报。先明确听众、希望他们作出的决定、允许使用的事实、页数和时间,再让模型搭结构、写逐页要点和讲稿。下面用一家虚构门店的办公楼下午茶配送试点,做出一份 6 页、约 8 分钟、可编辑且带逐页备注的决策提案。
本篇聚焦通用的职场决策提案;活动执行方案可参考活动策划案 PPT,教学课件可参考声音主题课件。
先把一句话扩成一张内容卡
起始需求可以写成:
给门店合伙人做一份关于是否试行办公楼下午茶配送的 6 页决策提案,约 8 分钟,说明试点边界、证据缺口、风险和需要审批的事项。
接着补上已知事实和限制条件。本次只使用以下虚构假设:试点 4 周、覆盖 2 栋办公楼、服务半径约 1.5 公里、工作日下午提供、每天最多接 15 单、由一家门店出品、预算上限 3,000 元且所有支出需事前审批。需求卡明确要求:不能编造调查、销量、客群、利润或成本;没有依据的目标写“试点后测量”;负责人和日期未知时写“待确认”。完整内容在练习包需求卡中。
现实演示文稿也要先区分“已经核实的数据”和“等待验证的假设”。如果资料涉及员工、客户或商业秘密,使用模型前先确认组织的处理流程与适用规则;本次模型输入全部是虚构内容。《个人信息保护法》
用本机 Qwen 生成结构化初稿
本例选择本机 Ollama 中的 Qwen3.8-27B:工作重点是中文归纳、按页拆分和撰写演讲备注,不需要联网检索或生成装饰图片,因此没有调用云端模型或生图服务。Qwen 项目提供模型和使用资料;Ollama 的本地生成接口支持 JSON 格式响应,便于把大纲交给后续脚本排版。Qwen3.8 官方仓库 Ollama API 文档
解压练习包,先安装并启动 Ollama,再运行:
ollama pull qwen3.8-27b:latest
python3 ask_qwen.py
实际模型标签以 ollama list 为准;若名称不同,可用 python3 ask_qwen.py --model 你的模型标签。脚本把需求卡和提示词发送到本机 127.0.0.1:11434,保存原始模型 JSON 和耗时信息。把 qwen_output.raw.json 视为未经审核的草稿,检查所有数字、风险、时间和负责人。
这次初稿出现了两类需要纠正的推断:需求卡没提供历史数据,模型却写成“没有历史销量或客群数据”;材料只说结束后根据投诉复盘,模型又增加“投诉高即终止”,但没有定义“高”的标准。编辑将这两处改为材料能支持的说法,并把未给出的启动负责人和日期保留为待确认。原始稿和校订稿都在包内,方便对照。
把校订稿生成 PPTX 和逐页讲稿
练习包用 PptxGenJS 4.0.1 将审校后的 JSON 生成 6 页宽屏 PPTX,并把演讲备注写入每页的 PowerPoint notes;另输出独立的 讲稿.md。PptxGenJS 的备注接口见官方文档。
npm install
npm run build
本次交付包含可编辑 PPTX 和 PDF。PPTX 文字可以继续修改;PDF 用于预览和转发。自己生成 PDF 时,可使用安装好的 LibreOffice 命令行导出。更换系统或软件后,检查中文字体、文本换行、每页备注和对象边界;需要时修改脚本中的字体名再导出。
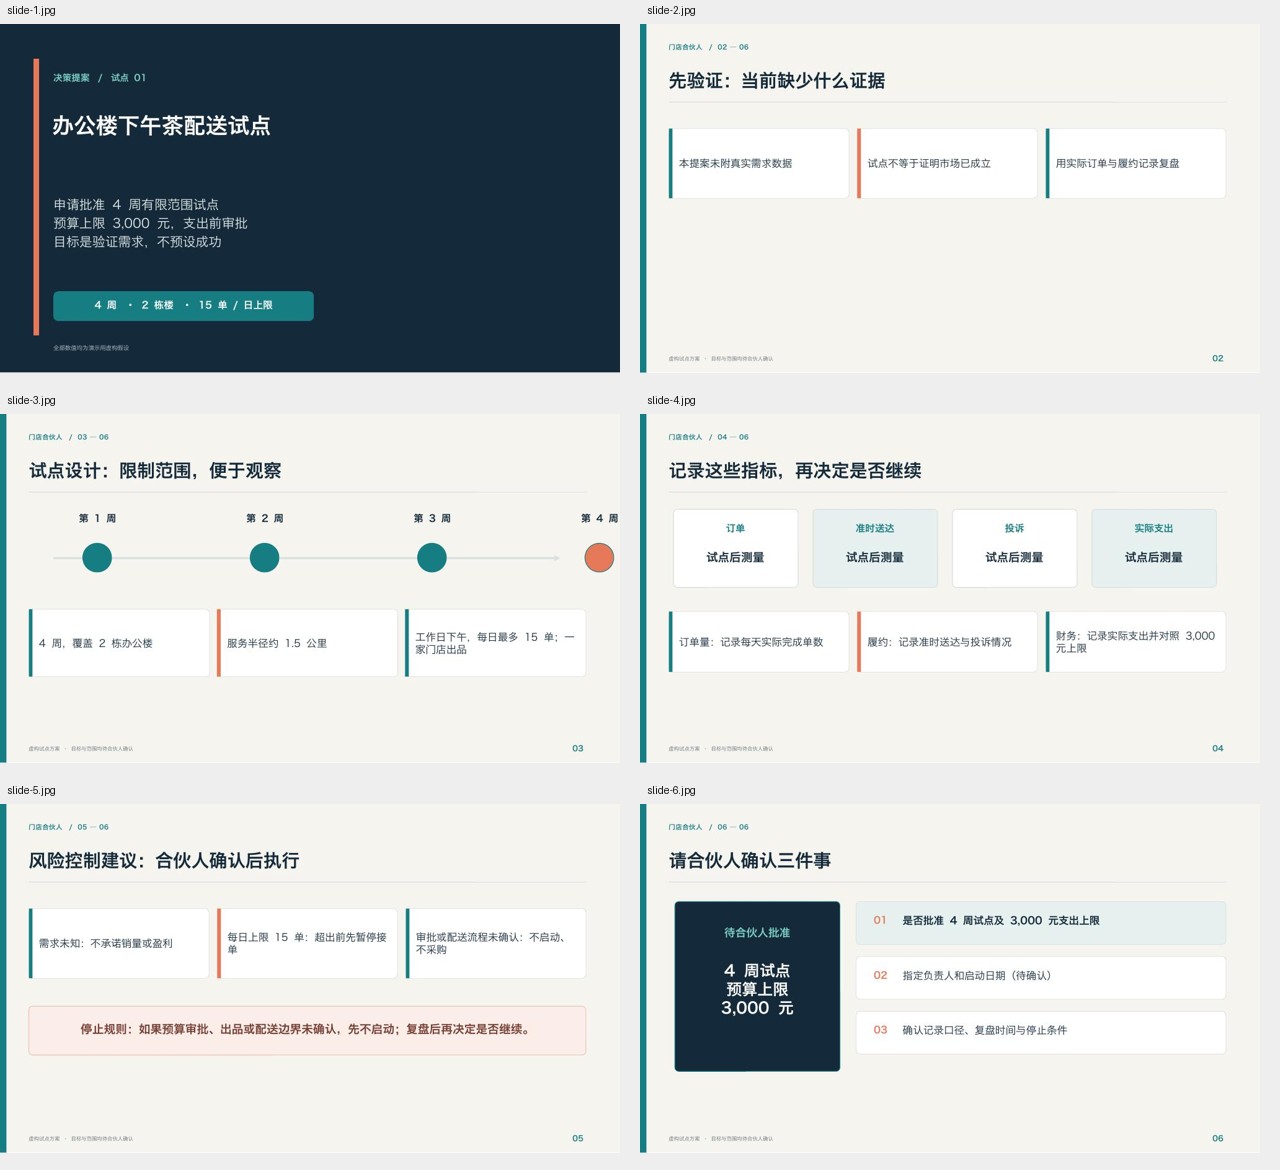 六页办公楼下午茶配送试点决策提案的排版预览
本机实测与复核
本机使用 Ollama 0.35.1 调用 qwen3.8-27b:latest,生成 6 页 JSON 初稿;生成用时 78.66 秒,模型加载 9.67 秒。校订后的内容生成 6 张幻灯片和 6 份演讲备注,并通过 LibreOffice 导出 PDF 检查中文显示与页面布局。完整计时在包内 model_metrics.json 和模型实测记录.md。
这验证了模型可以按需求卡产出一份可供编辑的提案初稿,不代表模型已证明下午茶业务可行,也不等同于合伙人批准。示例没有真实销售、市场或成本数据;正式汇报要把结论链接回可核查来源,讲清哪些是事实、估算或待决事项。
下载与使用
下载办公楼下午茶提案练习包,其中包含需求卡、提示词、原始模型输出、校订稿、调用脚本、PPTX、PDF、逐页讲稿和实测记录。把虚构需求卡换成自己的材料时,先删掉未经确认的数字,再逐页检查模型是否把建议写成结论。