
开完会要整理纪要,或要给课程视频加字幕,你可以把录音转成带时间码的 SRT 和按说话人分段的文字稿。FunASR 是阿里通义实验室维护的开源语音识别工具;这篇教程带你在 Mac 上本地跑中文模型,适合经常处理录音、又不想把音频交给在线转写服务的人。
下面这段约 50 秒的示例录音由 macOS 中文语音合成生成,不是真人会议录音:
试听合成的两人会议对话
我在 M1 Max、64GB 内存的 Mac 上,用 FunASR 1.4.16 跑过这段录音,生成了 SRT 字幕和分说话人的文字稿。示例里两人轮流说了 7 段,分段都标对;有 1 处同音字错误,交接处还有 2 处断句不准。识别结果需要人工校对,不能直接当正式会议纪要。
你需要准备
| 项目 | 说明 |
|---|---|
| 电脑 | 本文在 M1 Max、64GB 内存的 Mac 上验证;其他 Mac 的速度和兼容性可能不同 |
| 软件 | Python 3.11、uv;链接见下方准备步骤 |
| 网络和空间 | 安装依赖和首次下载模型时需要联网;这次实测首次模型下载约 2GB,实际会随模型版本变化 |
| 费用 | FunASR 和模型可按各自许可下载使用;本机转写不按分钟付云端费用,电脑和存储仍有成本 |
模型下载完成后,识别过程在本机运行,音频不会发到云端识别接口。首次安装和下载模型并非离线操作;如果会议内容敏感,也要先确认你有权保存和处理这段录音。
下载工具包
完整脚本在这个工具包里:下载 FunASR 会议转写工具包。解压后能看到 meeting_transcribe.py、安装说明和一段合成练习录音。
脚本会把 WAV 转成同名的 .srt 和 .txt:SRT 可导入剪映等字幕编辑器;TXT 按说话人和时间分段,适合整理纪要底稿。示例输出如下:
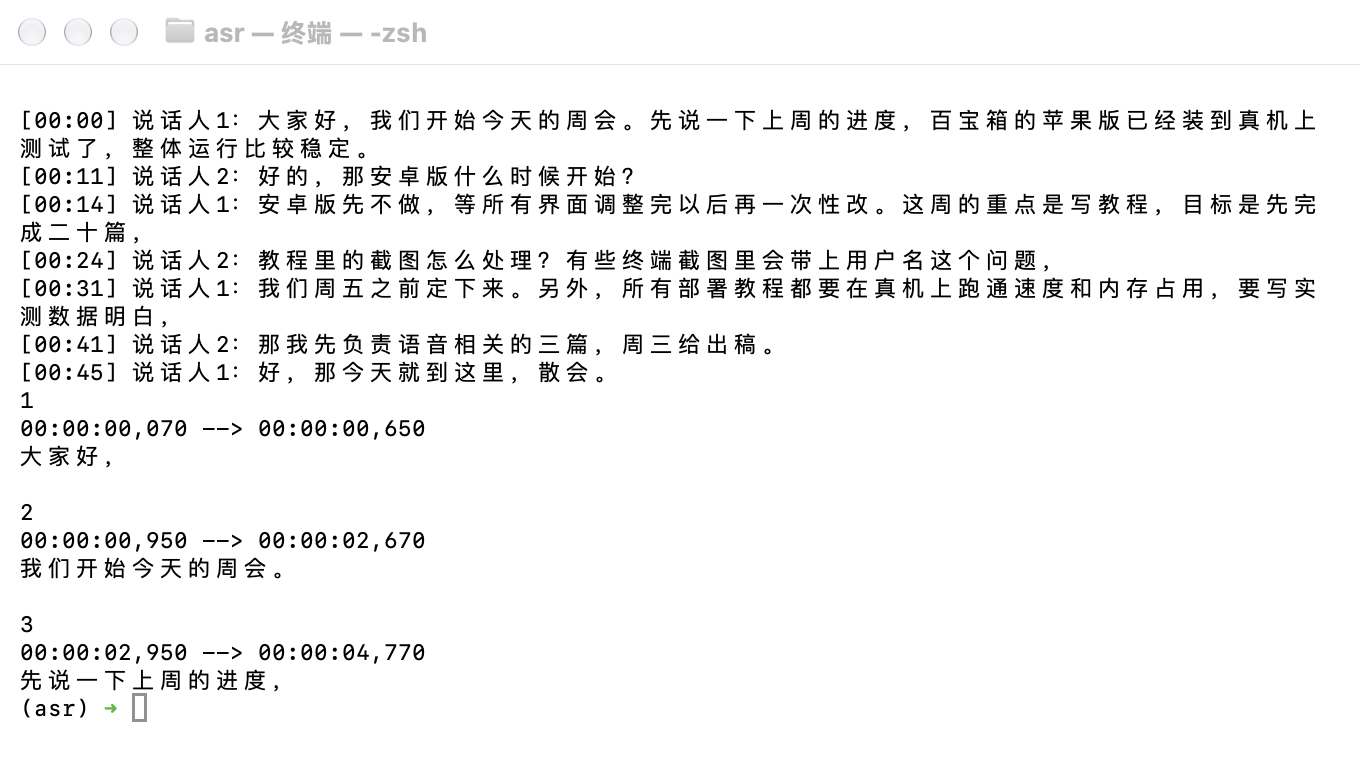 转写结果包含按说话人分段的文字稿和 SRT 字幕
安装 FunASR
FunASR 是 Python 工具,没有需要点击的桌面界面;你在终端里安装和运行。下面用 uv 建一个独立环境,避免和其他 Python 项目的依赖混在一起。第一次接触终端,可以先看终端入门和安装 Python 与虚拟环境。
在终端执行:
mkdir -p ~/ai-demo/asr && cd ~/ai-demo/asr
uv venv --python 3.11 --managed-python
source .venv/bin/activate
uv pip install "funasr==1.4.16" modelscope torch torchaudio "transformers>=4.45"
这组命令对应 2026 年 10 月 3 日记录的验证环境。FunASR、Torch 和 Torchaudio 的兼容关系会随版本变化;如安装失败,先核对FunASR 官方安装说明里的 Python 与 PyTorch 要求,再按你的 Mac 芯片选择匹配的 Torch/Torchaudio 版本。不要把 arm64 和 Intel 的 Python 包混装。
首次运行会下载 4 个组件:识别语音的 Paraformer、找出说话区间的 VAD、补标点的 CT-Transformer,以及区分说话人的 CAM++。首次启动通常会比后续运行久;终端显示下载或模型加载信息时先等它完成。模型准备好后,可以断网处理本地 WAV。
| 脚本里的名称 | 用途 | 本次实际加载的模型 |
|---|---|---|
paraformer-zh |
中文语音识别 | SeACo Paraformer |
fsmn-vad |
找出有语音的区间 | FSMN-VAD |
ct-punc |
给识别文本补标点 | CT-Transformer |
cam++ |
给不同声音片段加说话人标签 | CAM++ |
把录音转成文字和字幕
本工具包脚本接收 16kHz、单声道 WAV。Mac 自带 afconvert 可以把常见的 m4a 或 mp3 转成这个格式:
afconvert -f WAVE -d LEI16@16000 -c 1 "录音.m4a" "会议.wav"把 meeting_transcribe.py 放到录音旁边,再运行:
python meeting_transcribe.py "会议.wav"第一次运行会加载模型;完成后,录音所在目录会多出 会议.srt 和 会议.txt。模型会用 VAD 找出语音片段,用 Paraformer 识别文字,再加标点和说话人标签。你可以先播放原录音,再逐句检查专有名词、数字、发言人和时间码。
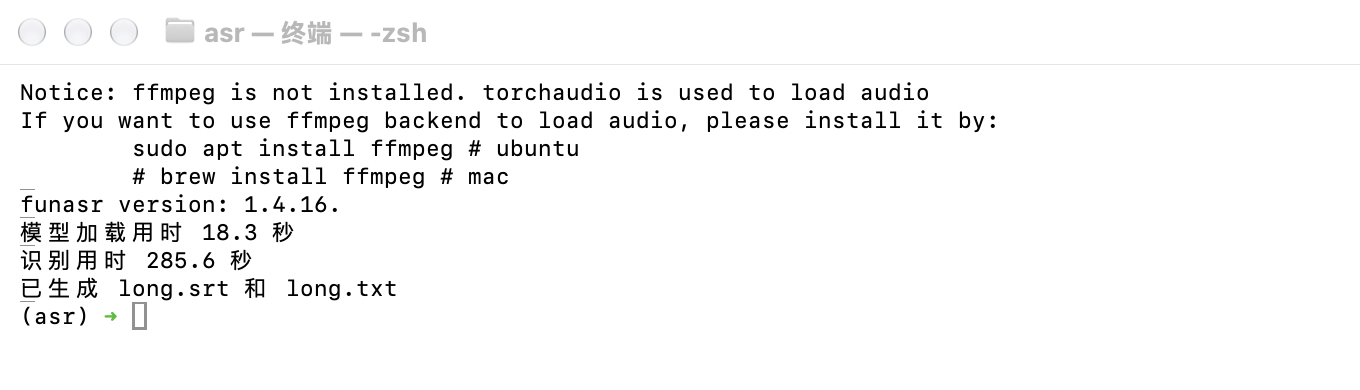 终端显示模型加载完成并输出字幕和文字稿
速度和识别效果
下面是 2026 年 10 月 3 日在 M1 Max、64GB Mac 上的记录,供你估算等待时间,不代表其他设备的速度:
| 音频 | 识别时间 | 结果 |
|---|---|---|
| 约 50 秒的合成对话 | 约 6 秒 | 7 段发言分对;1 个同音字错误、2 处交接断句不准 |
| 约 10 分钟的录音 | 约 4 分 46 秒 | 另一次本机运行记录;首次模型加载约 18 秒 |
多人同时说话、远距离收音、背景音乐、口音和人名都会降低效果。把转写稿作为初稿使用,特别核对姓名、金额、日期和任务负责人;需要对外发布时,先取得相关人员同意并检查内容。
常见问题
提示 Failed to load audio:先把 m4a 或 mp3 转为 16kHz 单声道 WAV,再把生成的 WAV 路径传给脚本。
第一次运行很久没反应:模型可能还在下载或加载。首次下载约 2GB 是这次旧环境的记录,实际下载量取决于模型和缓存;以后再运行通常不用重复下载完整模型。
说话人标签不够准:模型给出的“说话人1/2”是自动区分结果,不等于确认了真实身份。多人抢话、同一人离麦克风远近变化时,标签可能跳动;对照原音手工修正,不要用模型标签证明是谁说了某句话。
人名或产品名经常识别错:本次使用的 SeACo Paraformer 支持热词。热词写法和模型版本有关,先看模型卡中的调用示例,再按当前脚本接口添加。
能不能商用:FunASR 代码仓库采用 MIT 许可,但模型权重按各自模型卡或FunASR 模型协议执行,依赖库也有各自许可。商用前确认实际下载的模型 ID、署名要求和模型名保留要求;代码许可证不自动替代模型许可证。
用它做录音整理服务
如果你经常替客户整理访谈、课程或播客录音,可以把本地转写当作初稿环节:先确认客户有权提供录音,再转成文字和字幕,最后人工校正人名、数字、时间码和说话人。报价前先问清音频时长、是否需要逐字稿、时间轴、说话人校对和保密交付;各平台的同行报价差异很大,可以按同类服务的工作范围自行比价,不要只按模型跑完的时间估算。
交付时把原音、SRT 和校正后的文字稿分开命名;客户未授权时,不要把录音上传到在线模型做摘要,也不要在示例或作品集中公开原始对话。
工具入口
| 工具 | 用途 | 入口 |
|---|---|---|
| FunASR | 本地语音识别与说话人分段工具,免费开源 | 官方 GitHub · 安装说明 |
| SeACo Paraformer | 将中文语音识别成文字,支持热词 | ModelScope 模型页 |
| FSMN-VAD、CT-Transformer | 找语音区间、补标点 | VAD 模型 · 标点模型 |
| CAM++ | 辅助区分不同说话人 | ModelScope 模型页 |
| 本文脚本和练习录音 | 生成 SRT 与分段文字稿 | 下载工具包 |
如果你的录音不方便离开电脑,这条本地路线可以作为转写初稿;若要做最终会议纪要,仍需结合议程和原音人工整理。