
想在自己的电脑上试一个模型,先查已有设备,再选一个文件和小任务。下载文件能放进磁盘,只是第一步;运行时还需要内存、受支持的计算设备和合适的软件。
这篇是准备本地运行时的技术基础选读,不要求先买新电脑。只用AI网页或App的读者可以暂时跳过。模型文件名称先看《参数量 量化 GGUF 怎么看》,使用方式回看《App 网页 API 和本地运行怎么区分》。
内存、显存和磁盘,各管什么
| 项目 | 用来做什么 | 要避免的误解 |
|---|---|---|
| RAM(系统内存) | 程序运行时存放正在处理的数据 | 电脑标有16GB,不代表模型可独占16GB |
| VRAM(显存) | GPU进行计算时使用的内存资源 | 独显的专用显存与共享系统内存要分别看 |
| 统一内存 | CPU、GPU等共同使用的内存池,Apple芯片Mac采用这种设计 | 64GB统一内存不能等同任意电脑64GB独显显存 |
| 磁盘存储 | 保存软件、下载的模型和其他文件 | 磁盘空余多,不能直接解决运行内存不足 |
GPU是擅长并行计算的处理器。CPU也能执行模型计算;实际速度、GPU支持与能否分担到CPU,取决于软件、模型和设备。Ollama硬件文档提供了各平台支持条件。不要只凭“Intel”或“没有独显”就断言完全不能运行;先查软件支持,再尝试合适的小模型。
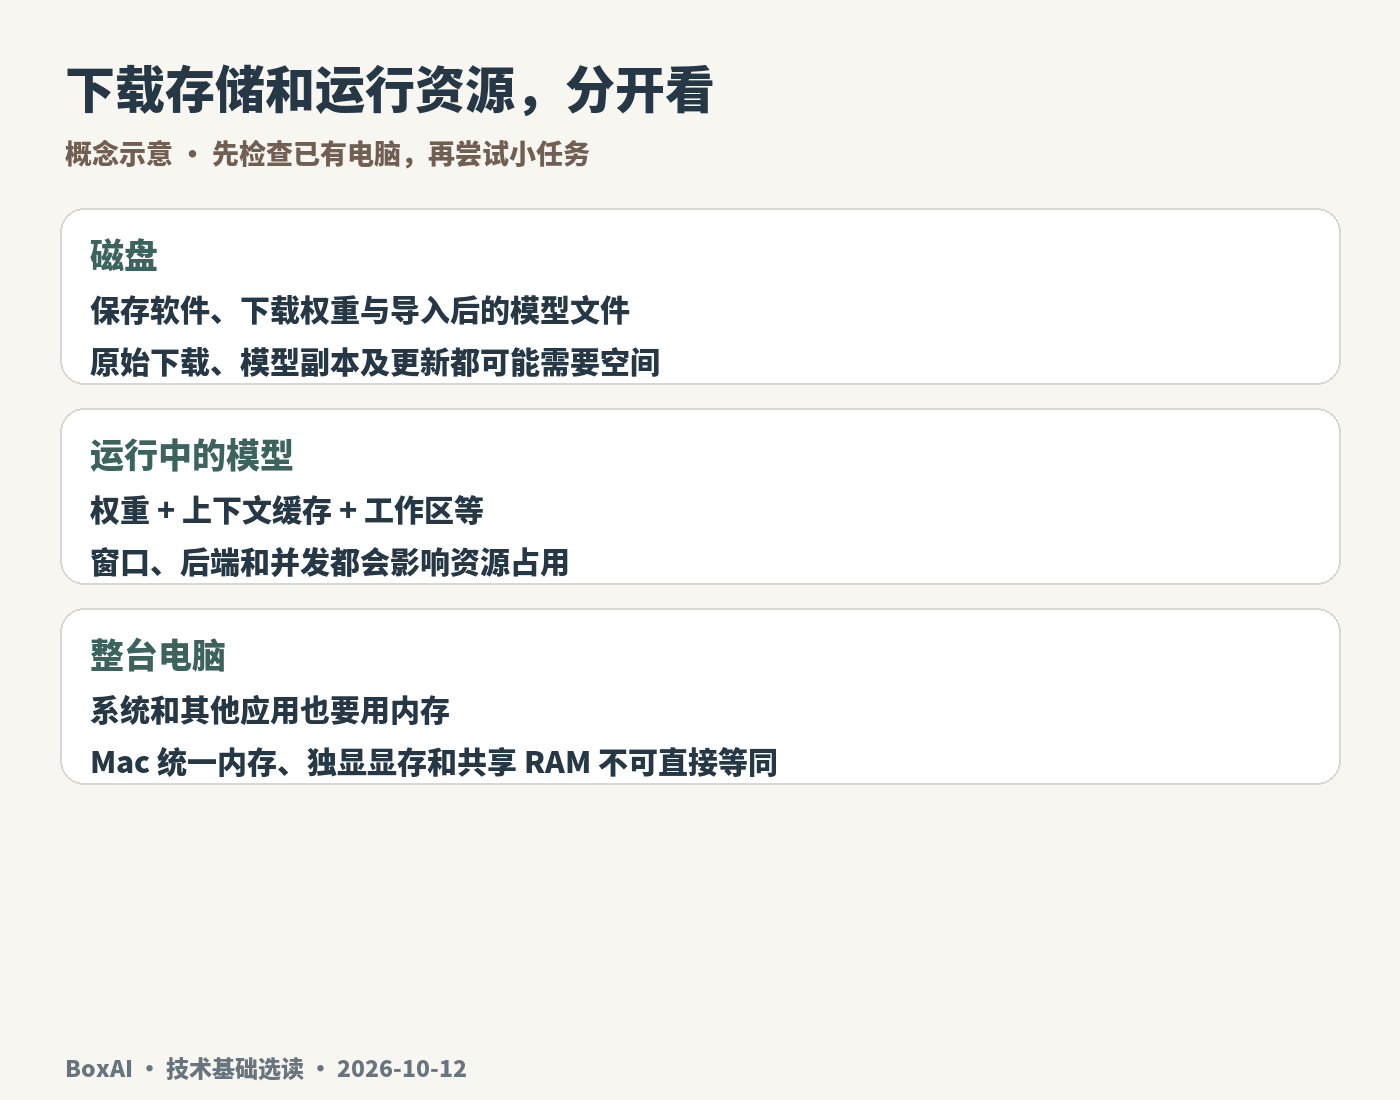 概念示意:磁盘保存文件,运行还要考虑权重、上下文缓存、工作区以及系统和其他程序。
在已有电脑上查三项信息
Mac
- 苹果菜单 →“关于本机”:记录芯片、内存和macOS版本。
- “系统设置 → 通用 → 存储空间”:看可用存储,而不只看硬盘总容量。Apple存储说明介绍了入口。
- 打开“活动监视器 → 内存”:运行模型前后观察内存压力、已使用内存和交换情况。绿色压力通常表示内存仍能较有效地服务当前工作;明显变黄、变红、交换增长或电脑卡顿时,要检查任务负担。不要只看“空闲内存”,Apple的内存说明解释了缓存与压力的关系。
Windows
按 Ctrl + Shift + Esc 打开任务管理器,在“性能”查看系统内存与GPU。GPU页面分别记录专用和共享GPU内存;共享部分借用系统RAM,不能简单加到专用显存上当作同等资源。再按Microsoft设备说明,在“设置 → 系统 → 存储”查看磁盘余量。
GPU名称、驱动和操作系统也要记录,随后对照所选软件的支持文档。Microsoft的说明介绍了任务管理器中的GPU与内存统计。本次没有Windows设备实测,以上是官方文档入口说明;界面名称可能随系统语言和版本变化。
本次电脑记录
本次在M1 Max Mac上实际读取系统信息:macOS 27.0.1,内存68,719,476,736字节,即64GiB(设备标称64GB)。测试所在磁盘当时可用约393GiB;可用量随其他文件变化。这里的64是已安装容量,不能当作运行时可用容量。
系统读取记录随材料包保存。界面入口依据官方说明,本次没有重新录制系统设置或活动监视器截图,也没有测整机峰值内存。桌面应用和闲置的ComfyUI服务仍在运行,测量对象是Ollama报告的已加载模型。
下载前,再检查文件与运行软件
先把以下信息写在一张便签上:
电脑:芯片/GPU、RAM、专用与共享显存、系统版本
软件:名称与版本,是否支持这台设备和模型架构
模型:发布者、精确文件名、量化、文件大小与许可证
任务:先用一段短文字,需要多长窗口、是否同时跑多个任务
磁盘:下载与导入是否会保留多份文件,更新时是否有余量本篇与术语篇使用同一个Qwen官方文件:Qwen3-0.6B-Q8_0.gguf,实际639,446,688字节,约609.82MiB;固定版本和SHA-256见前一篇。导入Ollama后,下载文件仍在原目录,模型存储中还会有权重等内容,预留空间要考虑这些文件与后续更新。材料ZIP不包含权重。
运行占用还包括上下文缓存、运行工作区等。系统、其他应用、并发任务也会占用资源;某些后端会分配额外缓冲或调整缓存。用“模型文件大小 + 一个固定数字”不能保证最低配置,也不能保证你要的响应速度。
实测:同一模型改窗口,占用怎么变化
本次软件Ollama 0.35.1,已安装并启动;没有重新安装。模型导入后,先发一条短读书会材料,再分别指定4,096和32,768 Token窗口。每种配置独立重新加载两次,避免沿用前一次模型的窗口配置。
两种配置都使用相同的短输入,关闭思考模式;固定 temperature=0、seed=42、num_predict=256、num_batch=128,本练习串行发出单次请求,未控制电脑上的其他服务作业。请求结束、模型尚未卸载时读取 /api/ps,并读取生成接口的输入Token计数。没有输入一篇32K Token长文,因此不是长文理解或满窗口压力测试。
| 配置 | 实际输入 | size 字节 |
size_vram 字节 |
约GiB | 两次结果 |
|---|---|---|---|---|---|
| 4,096窗口 | 75 Token | 1,136,960,470 | 1,136,960,470 | 1.06 | 相同 |
| 32,768窗口 | 75 Token | 4,550,085,836 | 4,550,085,836 | 4.24 | 相同 |
字段怎样读:
context_length:这次已经加载的运行窗口;实际读取,不能只看模型卡或软件说明的默认值。size:Ollama报告的已加载模型大小/占用统计。size_vram:其中软件报告归于GPU的部分。在Apple芯片上使用统一内存;不要把两列相加重复计算,也别把它当作一块独立显存的容量。prompt_eval_count:本次实际处理的输入Token数量,包含软件对提示的处理;不同模板和输入会改变它。
这些字段来自已加载模型接口和本次请求,不是整台Mac的总内存、进程峰值或通用最低配置。模型名称、文件、软件版本与具体请求都在材料记录中。
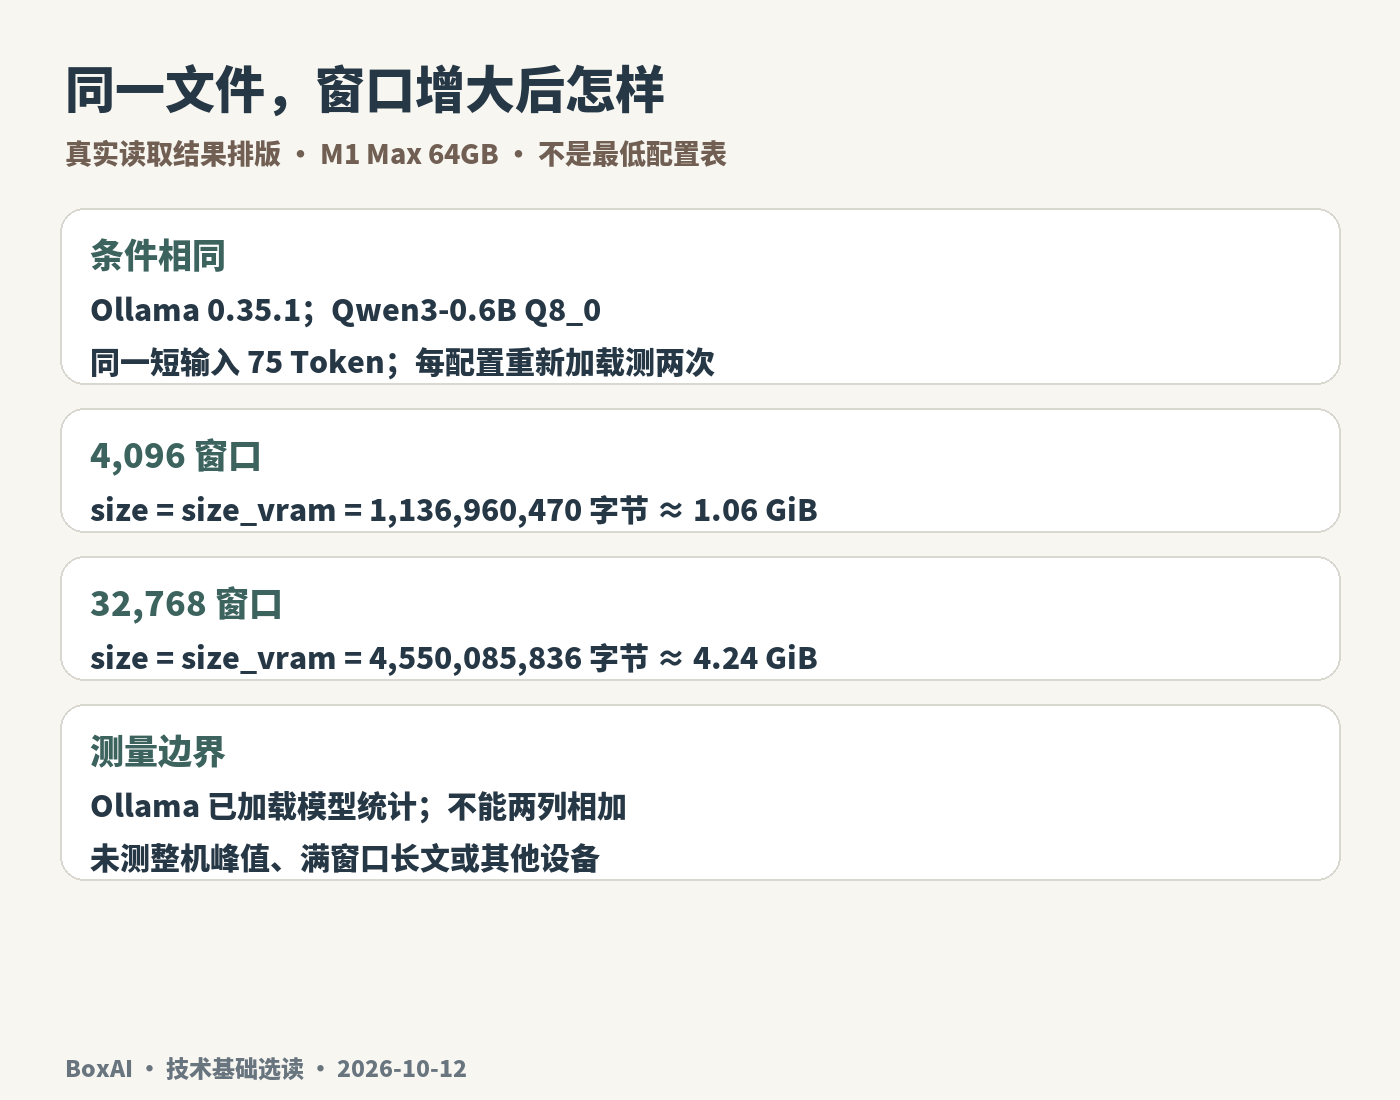 同一文件、两种窗口的真实读取结果;排版图不是软件截图,也不是最低配置推荐表。
同样约610MiB的下载文件,在本次配置下报告约1.06GiB和4.24GiB的已加载模型占用。窗口增大时,占用变化明显;这里没有改变输入长度,也没有得到适用于其他模型的固定倍数。两种配置都完成响应,时间和报名截止一致,地点出现与术语篇相同的扩写,使用前要按原材料复核。
模型卡写32,768上下文,文件元数据读出40,960;我们未把后一数字当作已验证的可用上限,也没有测40,960窗口。设置窗口、实际读取的窗口、输入Token和内容正确性需要分别核对。
可选:在自己的电脑上读一次配置
先按模型文件术语篇导入本次模型,确保Ollama已启动且模型名称一致。第一次接触本地模型时,只做短问题与 ollama ps 检查即可;后面的接口练习可以稍后再做。
ollama run boxai-basics-qwen3-06b-q8 --think=false "请把这句活动时间原样复述:10月24日14:00–15:00。"
ollama ps运行中或尚未自动卸载时,ollama ps 会显示SIZE、PROCESSOR与CONTEXT等列。模型已卸载时列表可能为空,先运行一次再查看;PROCESSOR帮助判断GPU/CPU分担情况,软件版本可能影响显示格式。CLI中的大小可能经过舍入,不能与原始字节记录逐位对比。
想复现本文两种窗口,下载本篇材料包,进入包含 request-4096.json 的 b3 文件夹,先查看两个请求文件。以下逐行执行:
ollama stop boxai-basics-qwen3-06b-q8
curl -f http://127.0.0.1:11434/api/generate -H 'Content-Type: application/json' --data-binary @request-4096.json
curl -f http://127.0.0.1:11434/api/ps
第二行把材料中的短请求交给本机Ollama,等待返回;第三行读取模型运行信息。记录字段后,再停止本次模型,把第二行文件名换为 request-32768.json,重复生成与读取。32K窗口会占用更多资源;先确认短窗口运行稳定、电脑仍有余量,再尝试。
127.0.0.1 指这台电脑;这两份请求指定我们刚导入的本地模型,实际请求成功记录已保存。本次未做断网隔离测试。其他聊天界面可能连接云端或启用网络工具,上传资料前应确认所选模型与连接,不能只凭“安装了本地软件”承诺所有功能都不上传。
测试结束:
ollama stop boxai-basics-qwen3-06b-q8它停止本次模型,保留模型文件;不用停止其他正在工作的模型。
不够用时,按什么顺序处理
先确认没有同时加载多个模型或运行不需要的重任务;再按任务缩短输入、调小窗口,必要时换更小且支持的模型。量化方案要按发布者实际文件与任务效果选择。内存压力、交换和响应卡顿仍明显时,暂停扩大任务,再判断已有设备是否适合。
成功回答一次,能说明这次配置和短输入跑通。不能据此承诺批量处理、长文理解、所有模型速度或另一台电脑的体验。本篇没有购机或显卡推荐,也没有使用旧稿缺少条件记录的占用和速度数字。
材料与下一步
下载本地运行资源核对材料:两份可读请求、真实响应与占用字段、系统配置、模型来源及README;不含模型权重、账号资料或API Key。第一次阅读只要能找到自己的配置、区分磁盘与运行资源、知道该核对什么,就达到了目标。
准备开始安装时读《Mac 上安装 Ollama》的安装部分;下载练习模型仍按模型文件术语篇选择。技术选读按需要继续,不把硬件准备当成所有AI使用的前提。
封面背景由本机ComfyUI / Z-Image-Turbo生成,标题由代码排版;正文图为概念示意或真实结果排版。