
准备下载第一个本地模型,你会遇到类似 Qwen3-0.6B-Q8_0.gguf 的文件名。先把它拆开,再看发布者、文件清单和运行软件,就能知道自己正在下载什么。
这篇适合已经认识产品与模型、准备尝试本地运行的读者。普通聊天术语先读《产品 模型 提示词 上下文 Token 都是什么意思》;只是用 AI App 的读者可以以后再看。
用一份真实文件认识五个信息
我们选择 Qwen 官方发布的一个小模型文件,用来做导入和短对话练习。选择它是为了容易核对文件与运行条件,不代表它适合所有任务。
Qwen3-0.6B-Q8_0.gguf
│ │ │ └─ GGUF文件格式
│ │ └────── Q8_0量化方式
│ └─────────── 0.6B参数规模标签
└──────────────── Qwen3模型系列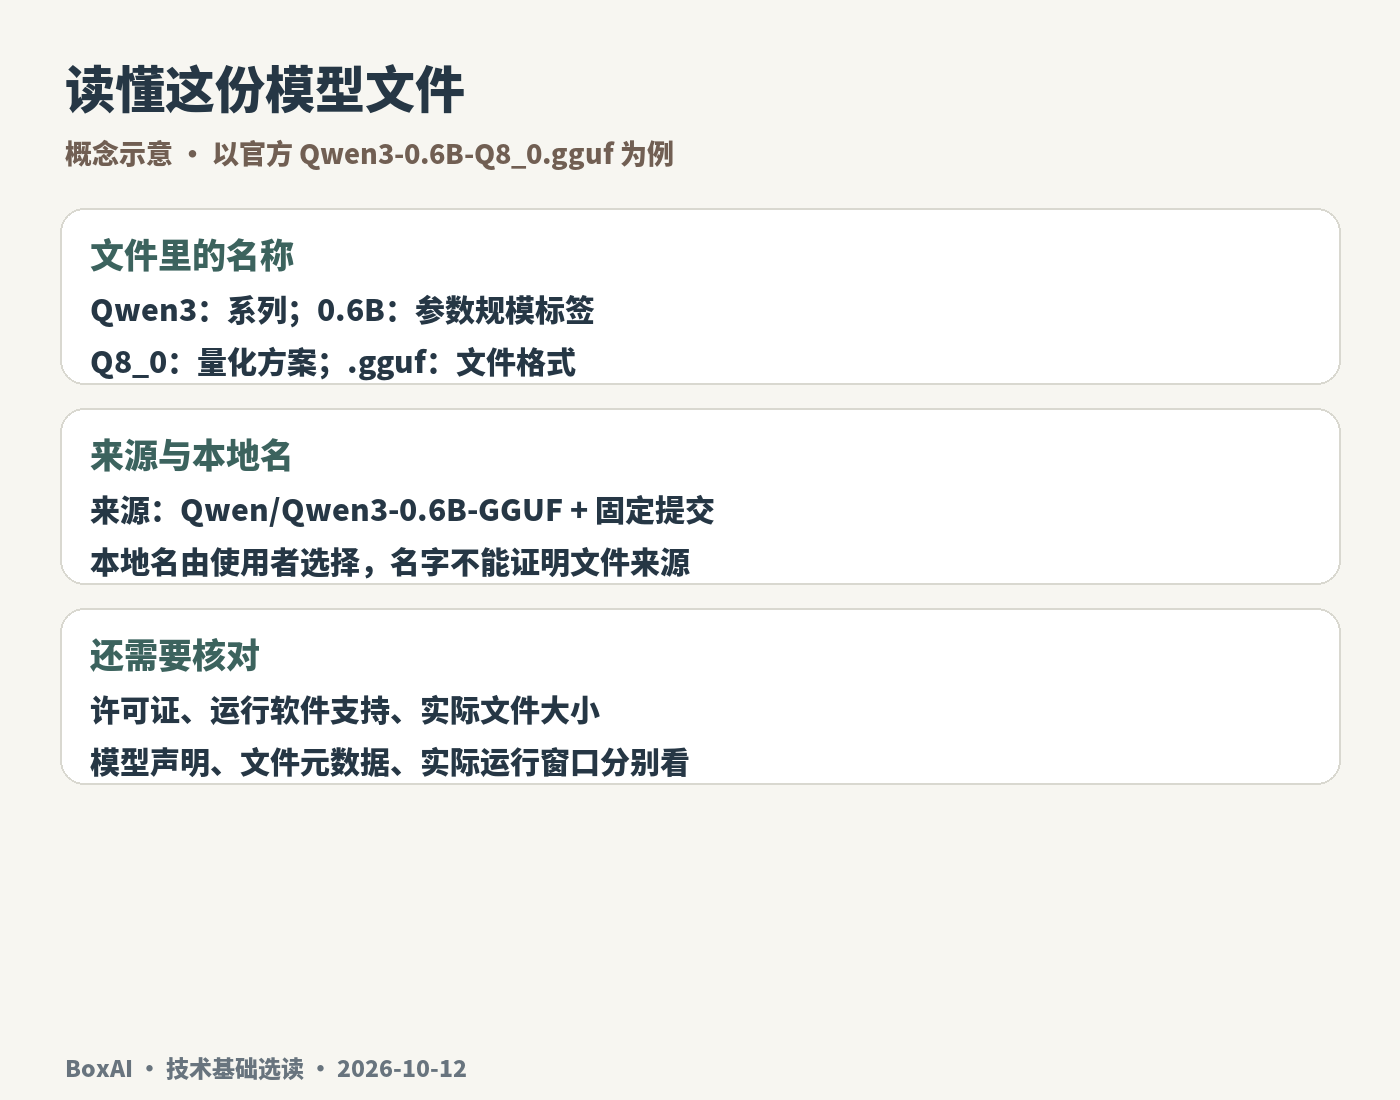 概念示意:文件名、发布仓库、本地名称和运行配置需要分别查看。
| 本次核对项 | 记录 |
|---|---|
| 发布者与仓库 | Qwen/Qwen3-0.6B-GGUF,Qwen 官方账户 |
| 文件名 | Qwen3-0.6B-Q8_0.gguf |
| 固定版本 | 仓库提交 23749fefcc72300e3a2ad315e1317431b06b590a |
| 实际下载大小 | 639,446,688 字节,约 639.45 MB / 609.82 MiB |
| 模型卡许可证 | Apache-2.0;使用和分发仍需查看许可证条件 |
| 模型卡上下文长度 | 32,768 Token |
| 本次运行软件 | Ollama 0.35.1,M1 Max、64GB、macOS 27.0.1 |
模型卡、固定文件清单于2026年10月12日核对;文件大小和校验值来自本次实际下载。MB按百万字节、MiB按1,048,576字节计算,因此界面显示的近似数字可能不同。
B 是参数数量级
参数是模型学习过程中形成、用于计算的数值。B 是 billion,表示十亿;0.6B 约为6亿,8B 约为80亿。文件名常用近似规模,精确数值应查模型信息。
本次Ollama实际读取 general.parameter_count=596049920,界面显示约 596.05M(M表示百万)。文件名的0.6B是规模标签,并不是精确的600,000,000。
参数数量不能单独告诉你模型会不会正确完成任务。训练数据、方法、模型结构、量化、指令和输入材料都会影响表现。同样叫8B,实际文件大小和运行占用也可能不同;不用统一常数把参数量换成最低内存。
Q8_0 是量化方式
量化是改变权重等数值的表示精度,以降低存储或运行成本。Q8_0 属于8位量化方案;Q4_K_M 等名字表示另一套具体方案,字母和后缀也有含义,不能只保留一个数字来判断。
它会改变模型用于计算的数值,效果和速度可能随模型、任务、运行后端而变化。**“Q8几乎无损”“Q4总是最佳选择”都不能作为通用保证。**选型时先确认发布者提供的实际文件,再试自己的任务。
本次固定版本的官方文件清单只提供这个 Q8_0 文件。没有在同一设备比较Q4与Q8,也没有重新量化,所以本文不做精度或速度排名。Ollama 的导入文档也说明,导入已有 GGUF 时不会自动把它再量化。
GGUF 是文件格式
GGUF格式规范定义了模型张量和元数据的存储。张量可以先理解成装有很多数值的数组;元数据帮助软件认识模型结构、分词等信息。
.gguf 后缀告诉你格式,但运行软件还要支持里面的模型架构和量化方式。某个文件能导入Ollama,不能推出所有GGUF在任意版本的软件里都能运行。
有的模型是一份文件,有的分成多份。遇到分片,要按发布清单收齐并保持名称,再按运行软件说明导入。本篇只有单文件,暂不展开分片、格式转换或量化制作。
标签、本地名称和文件名各在哪里看
这次官方仓库名是 Qwen/Qwen3-0.6B-GGUF:前面的 Qwen 是发布账户,后面是仓库。实际下载的文件还带有量化和后缀。
下面导入时,我们自定义本地名称 boxai-basics-qwen3-06b-q8。Ollama列表中可能补成 boxai-basics-qwen3-06b-q8:latest;冒号后是标签。名字由我们选择,不能单凭它证明发布者、量化或文件版本。
latest 这样的标签可能随重新创建或更新而改变。要复现一次练习,留下发布仓库、固定版本、原始文件名和校验值,再记录运行软件读出的信息。实际配置由软件和请求决定,也不是文件名的一部分。
上下文上限与这次使用量要分开
模型卡中的32,768,是这个模型声明的上下文长度。运行时可以配置较小的窗口,例如4,096;这次实际输入只是一段短材料,Token用量远小于窗口。
本次还发现一处差异:官方模型卡写32,768,下载文件的元数据由Ollama读出 qwen3.context_length=40960。两者不能混写成同一个“已验证上限”。本轮只实测4,096和32,768的运行配置,均读取到对应窗口;相同短输入计数为75 Token。没有测试40,960满窗口、长文质量或截断边界。
窗口内通常要容纳提示词、实际发送的对话或材料,以及生成内容。长窗口可能需要更多内存,也不能保证模型正确理解窗口里的每个事实。Token不能按固定中文字符比例精确换算,运行软件报告的计数才是这次请求的观察值。
可选操作:导入文件并问一次
这一节需要已经安装并启动Ollama、会使用终端。尚未准备好可以先读《本地运行 AI 前,怎么查看内存 显存和存储需求》,再读《Mac 上安装 Ollama》的安装部分;本篇练习使用的文件仍按下列步骤选择。
- 打开固定版本文件页,确认仓库和文件名,下载到一个新练习文件夹。
- 下载文末材料包,把其中的
Modelfile放到模型文件旁边。它是运行配置文件,内容如下:
FROM ./Qwen3-0.6B-Q8_0.gguf
PARAMETER num_ctx 4096
第一行指向当前目录中的权重文件;第二行把本练习窗口设为4,096。模型文件不放进材料包,需要从发布者处单独下载。
- 在终端进入这个练习文件夹,先核对文件名与校验值:
ls
shasum -a 256 Qwen3-0.6B-Q8_0.gguf
本次实际值如下,材料中的“模型来源.json”也有完整记录:
9465e63a22add5354d9bb4b99e90117043c7124007664907259bd16d043bb031校验值相符说明字节与记录一致;来源可信还要看发布账户和下载路径,不能只看校验通过。
- 导入并查看模型:
ollama create boxai-basics-qwen3-06b-q8 -f Modelfile
ollama show boxai-basics-qwen3-06b-q8
如果已有同名本地模型,先换一个新名称,并让后续命令一致,避免覆盖已有配置。导入会占用Ollama的模型存储,下载目录中的原文件仍在磁盘上。
- 发出一条短问题;这是一整行命令:
ollama run boxai-basics-qwen3-06b-q8 --think=false "请只按三项列出活动时间、地点和报名截止,不添加其他事实。材料:青禾社区读书会,10月24日14:00–15:00,社区二楼活动室,报名截止10月22日18:00。"本次终端实际回答:
活动时间:10月24日 14:00–15:00
活动地点:青禾社区二楼活动室
报名截止:10月22日 18:00
时间和报名截止与材料一致。地点被扩写为“青禾社区二楼活动室”,复核时应按原材料保留“社区二楼活动室”的写法,不把模型补出的文字自动当成新增事实。实际回答和原始材料同时保存在材料包中。
回答需要回到材料核对。成功导入、能生成文字与事实正确是不同检查;这个小模型的其他任务能力未在本文验证。
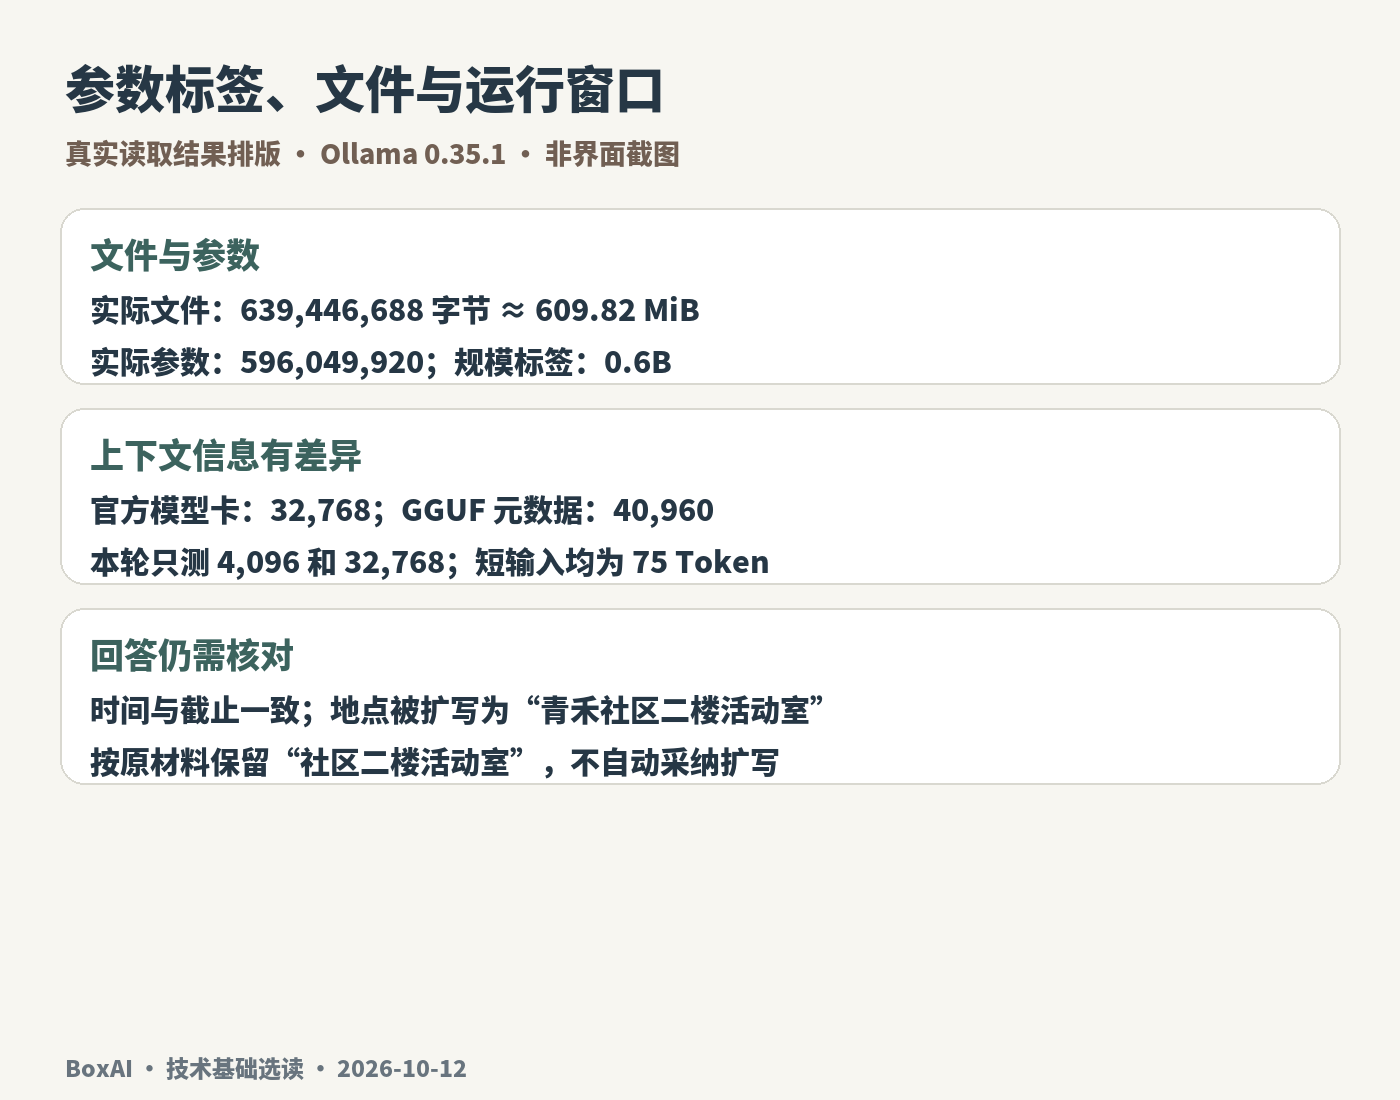 本次软件读取的模型信息与短材料核对;真实结果排版,非软件界面截图。
练习完可以停止本次模型,释放其运行占用;文件会保留供下次使用:
ollama stop boxai-basics-qwen3-06b-q8先学到这里就够了
下载时,按“发布者 → 精确文件 → 许可 → 软件支持 → 实际文件大小 → 运行配置 → 小任务核对”的顺序查看。遇到MoE(混合专家)、蒸馏或训练精度等术语,可以等相关任务需要时再读专门说明;它们不会替代上述核对。
下载模型文件认识练习材料:配置文件、来源与校验信息、短问题的实际回答、匿名化实测记录及说明。不含模型权重。接着读《本地运行 AI 前,怎么查看内存 显存和存储需求》,用这同一个文件认识磁盘和运行内存的区别。
封面背景由本机ComfyUI / Z-Image-Turbo生成,标题由代码排版;正文图为概念示意或真实结果排版。